Rechtschreibung: Trefferquote und Zahlen in Abschlussarbeiten
 Fachlich geprüft von Benjamin Lohrer, Lektor bei korrektur.de · Stand: 5. November 2026
Alte Schreibung (gewertet ab 2007): in wie vielen Arbeiten das Wort vorkommt
Bereinigte Untergrenze je 1.000 Wörter
| Fehlerart | mindestens je 1.000 Wörter | Bereich | Trefferquote (Bereich) |
|---|---|---|---|
| Getrennt- und Zusammenschreibung | 0,24 | 0,21 bis 0,26 | 72,5 % (63,9 bis 79,7) |
| Wortverwechslung | 0,040 | 0,035 bis 0,044 | 71,7 % (63,0 bis 79,0) |
Arten ohne Zahl: nur Rang und Trefferquote
| Fehlerart | Rang bei den Meldungen | Trefferquote (Bereich) | Urteile |
|---|---|---|---|
| Rechtschreibung | 3 von 7 | 43,3 % (34,8 bis 52,3) | 120 |
| Groß- und Kleinschreibung | 4 von 7 | 65,8 % (57,0 bis 73,7) | 120 |
Alte Schreibung ab 2007 gewertet, Zahl der Arbeiten
| Alte Schreibung | Richtige Schreibung | Arbeiten |
|---|---|---|
| daß | dass | 37 |
| muß | muss | 13 |
| läßt | lässt | 12 |
| Einfluß | Einfluss | 6 |
| mußte | musste | 5 |
| bewußt | bewusst | 4 |
| müßte | müsste | 4 |
| Prozeß | Prozess | 3 |
| Schloß | Schloss | 3 |
| Schlußfolgerungen | Schlussfolgerungen | 3 |
| plaziert | platziert | 3 |
Rechtschreibfehler: Was sich beziffern lässt
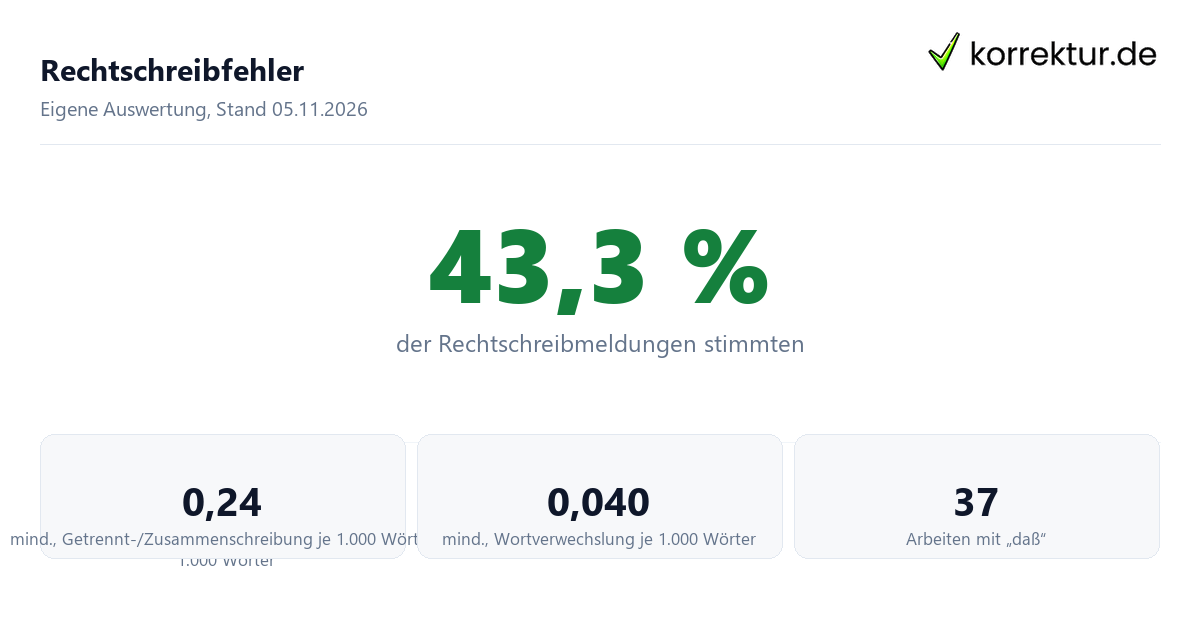
Nach der eigenen Auswertung von 950 offenen Abschlussarbeiten durch korrektur.de (Stand 5. November 2026) weist das Feld der Getrennt- und Zusammenschreibung nach der Bereinigung mindestens 0,24 Fehler pro 1.000 Wörter (Bereich 0,21 bis 0,26) auf, und bei der Wortverwechslung zeigen sich nach der Bereinigung mindestens 0,040 Fehler pro 1.000 Wörter (Bereich 0,035 bis 0,044), während automatische Meldungen zur Rechtschreibung selbst nach einem strengen Filter in der geprüften Stichprobe nur zu 43,3 Prozent (Bereich 34,8 bis 52,3 Prozent) zutreffen. Für die Rechtschreibung auf Rang 3 von 7 und die Groß- und Kleinschreibung auf Rang 4 von 7 bei der Anzahl der gefilterten Meldungen nennt diese Rechtschreibfehler-Statistik keine konkreten Fehlerzahlen, da ihre ermittelten Trefferquoten jeweils unter dem festgelegten Grenzwert von 70 Prozent bleiben. Sämtliche Angaben beziehen sich ausschließlich auf das untersuchte Textkorpus mit 4.712.082 Wörtern aus 8 Hochschulquellen der Entstehungsjahre 2003 bis 2026 ohne Kundentexte und stellen wegen des gezielt auf Genauigkeit statt Vollständigkeit ausgerichteten Filters methodische Untergrenzen dar.
Kurzantwort zur Rechtschreibfehler-Statistik in Abschlussarbeiten
Nach der eigenen Auswertung von korrektur.de im untersuchten Textkorpus aus 950 offenen Abschlussarbeiten mit insgesamt 4.712.082 Wörtern aus 8 Hochschulquellen (Stand 5. November 2026) erreicht das Prüffeld der Getrennt- und Zusammenschreibung nach der Bereinigung mindestens 0,24 Fehler pro 1.000 Wörter (Bereich 0,21 bis 0,26, was im Gesamtkorpus mindestens etwa 1.117 bestätigten Textstellen im Bereich 985 bis 1.228 entspricht), während bei der Wortverwechslung nach der Bereinigung mindestens 0,040 Fehler pro 1.000 Wörter (Bereich 0,035 bis 0,044, also im Gesamtkorpus mindestens etwa 189 betroffenen Textstellen im Bereich 166 bis 208) vorliegen. Als wichtigster Zusatzbefund dieser Rechtschreibfehler-Statistik erweisen sich die automatischen Prüfmeldungen zur Rechtschreibung selbst nach einem strengen Vorfilter zur Entfernung bekannter Fehlalarme in der beurteilten Zufallsstichprobe von 120 Einzelurteilen lediglich zu 43,3 Prozent (Bereich 34,8 bis 52,3 Prozent) als tatsächliche Verstöße, weshalb für diese Fehlerart auf Rang 3 von 7 ebenso wie für die Groß- und Kleinschreibung auf Rang 4 von 7 mit einer ermittelten Trefferquote von 65,8 Prozent (Bereich 57,0 bis 73,7 Prozent auf Basis von 120 Einzelurteilen) wegen Unterschreitung des festgelegten methodischen Grenzwerts von 70 Prozent bei mindestens 100 vorliegenden Urteilen keine konkrete Fehlerzahl, sondern ausschließlich die jeweilige Position in der Rangfolge bei der Anzahl gefilterter Meldungen ausgewiesen wird. Die methodische Grenze der gesamten statistischen Aussage besteht darin, dass die ausgewertete Datenbasis ausschließlich offene Abschlussarbeiten der Entstehungsjahre 2003 bis 2026 ohne jegliche Kundentexte von korrektur.de abbildet, die Einzelbewertungen der gezogenen Stichproben durch ein nach festen Regeln arbeitendes KI-Modell mit stichprobenartiger Gegenprüfung ohne Beteiligung menschlicher Lektorinnen oder Lektoren erfolgten und sämtliche bereinigten Häufigkeitswerte als Produkt aus gefilterten Meldungen und Trefferquote aufgrund des gezielt auf hohe Genauigkeit statt auf Vollständigkeit ausgelegten Filters zwingend als methodische Untergrenzen zu verstehen sind, weil vom eingesetzten Prüfverfahren überhaupt nicht gemeldete Verstöße in der Zählung vollständig unberücksichtigt bleiben.
Bezifferbare Fehlerarten und ihre Untergrenzen im Korpus
In der Auswertung der 950 offenen Abschlussarbeiten mit insgesamt 4.712.082 Wörtern aus 8 Hochschulquellen der Entstehungsjahre 2003 bis 2026 durch korrektur.de (Stand 5. November 2026) überschreiten von den vier Fehlerarten dieser Seite genau zwei die Schwelle für eine Fehlerzahl: die Getrennt- und Zusammenschreibung und die Wortverwechslung. Die Schwelle sind mindestens 70 Prozent Trefferquote bei wenigstens 100 Einzelurteilen. Für die Getrennt- und Zusammenschreibung belegt die Messung nach der rechnerischen Bereinigung über die Trefferquote mindestens 0,24 Fehler pro 1.000 Wörter (Bereich 0,21 bis 0,26), was im untersuchten Gesamtkorpus mindestens etwa 1.117 bestätigten Textstellen (Bereich 985 bis 1.228 Stellen) entspricht; die Trefferquote der im Einzelurteil überprüften Meldungen liegt in dieser Kategorie bei 72,5 Prozent (Bereich 63,9 bis 79,7 Prozent) auf der Grundlage von 120 ausgewerteten Urteilen. Bei der Wortverwechslung weisen die erhobenen Korpusdaten nach der Bereinigung mindestens 0,040 Fehler pro 1.000 Wörter (Bereich 0,035 bis 0,044) und damit im Gesamtkorpus mindestens etwa 189 betroffene Textstellen (Bereich 166 bis 208 Stellen) aus, gestützt auf eine ermittelte Trefferquote von 71,7 Prozent (Bereich 63,0 bis 79,0 Prozent) bei ebenfalls 120 geprüften Einzelurteilen.
Beide bereinigten Häufigkeitswerte für die offenen Abschlussarbeiten musst du bei der fachlichen Einordnung und beim Zitieren zwingend als methodische Untergrenze verstehen. Das eingesetzte zweistufige Prüfverfahren aus der automatischen Prüfung durch LanguageTool und dem nachgeschalteten Filter zur Entfernung bekannter Fehlalarme ist gezielt auf hohe Genauigkeit statt auf Vollständigkeit ausgerichtet, sodass vom Prüfprogramm überhaupt nicht gemeldete oder durch den strengen Filter vorab aussortierte Verstöße nicht in die bereinigten Zahlen aus Meldungen mal Trefferquote einfließen. Sämtliche Einzelurteile in den Zufallsstichproben stammen dabei von einem nach festen Regeln arbeitenden KI-Modell mit stichprobenartiger Gegenprüfung ohne Beteiligung menschlicher Lektorinnen oder Lektoren, wobei die angegebenen Intervalle der Trefferquoten jeweils den statistischen Wilson-Bereich mit 95 Prozent Sicherheit für das untersuchte Korpus ohne Kundentexte abbilden. Anders verhält es sich bei den beiden weiteren untersuchten Kategorien Rechtschreibung auf Rang 3 von 7 bei der Zahl gefilterter Meldungen mit einer Trefferquote von 43,3 Prozent (Bereich 34,8 bis 52,3 Prozent bei 120 Einzelurteilen) sowie Groß- und Kleinschreibung auf Rang 4 von 7 mit einer Trefferquote von 65,8 Prozent (Bereich 57,0 bis 73,7 Prozent bei 120 Einzelurteilen), für die wegen der Unterschreitung des Grenzwerts von 70 Prozent keine konkreten Fehlerzahlen, sondern ausschließlich die Ränge ausgewiesen werden. Wenn du dich ergänzend zu diesen Ergebnissen auch über andere sprachliche Prüfbereiche informieren möchtest, kannst du die Statistik zu Grammatikfehlern sowie die Statistik zu Zeichensetzungsfehlern aufrufen.
| Fehlerart | Bereinigte Zahl pro 1.000 Wörter (Untergrenze) | Bereich pro 1.000 Wörter | Stellen im Korpus (Untergrenze) | Trefferquote (bei 120 Urteilen) | Wilson-Bereich der Trefferquote |
|---|---|---|---|---|---|
| Getrennt- und Zusammenschreibung | mindestens 0,24 | 0,21 bis 0,26 | mindestens etwa 1.117 (Bereich 985 bis 1.228) | 72,5 Prozent | 63,9 bis 79,7 Prozent |
| Wortverwechslung | mindestens 0,040 | 0,035 bis 0,044 | mindestens etwa 189 (Bereich 166 bis 208) | 71,7 Prozent | 63,0 bis 79,0 Prozent |
Warum zwei Kategorien nur als Rangfolge ausgewiesen werden
Für die Kategorien Rechtschreibung und Groß- und Kleinschreibung weist diese Rechtschreibfehler-Statistik bewusst keine bereinigte Fehlerzahl und auch keine absolute Meldungszahl aus. Bei der Zahl der gefilterten Meldungen belegt die Rechtschreibung Rang 3 von 7, wobei ausschließlich diese Reihenfolge belastbar ist. In der Zufallsstichprobe von 120 Urteilen erreicht die Rechtschreibung eine Trefferquote von lediglich 43,3 Prozent (Bereich 34,8 bis 52,3). Da dieser Wert unter dem festgelegten Grenzwert bleibt, wird keine Fehlerzahl genannt: Der zentrale Befund lautet vielmehr, dass automatische Meldungen zur Rechtschreibung auch nach strengem Filter nur zu 43,3 Prozent stimmen.
Ein ähnliches Bild zeigt sich bei der Groß- und Kleinschreibung, die bei der Zahl gefilterter Meldungen auf Rang 4 von 7 liegt und für die ebenfalls nur diese Reihenfolge ausgewiesen wird. Hier beträgt die Trefferquote in der Stichprobe aus 120 Urteilen 65,8 Prozent (Bereich 57,0 bis 73,7) und verfehlt damit ebenfalls den Grenzwert, weshalb keine Fehlerzahl ausgewiesen wird. Der methodische Grund für den Verzicht auf eine Bezifferung bei beiden Kategorien ist eindeutig festgelegt: Sobald die Trefferquote unter dem Grenzwert von 70 Prozent liegt oder weniger als 100 Urteile vorliegen, ist lediglich die Rangfolge der gefilterten Meldungen belastbar, während eine berechnete Fehlerzahl geraten wäre.
Bei der Deutung der Trefferquote für die Rechtschreibung von 43,3 Prozent (Bereich 34,8 bis 52,3) ist sprachliche Sorgfalt geboten. Der Punktwert liegt bei 43,3 Prozent, der Bereich reicht von 34,8 bis 52,3 Prozent und damit über die Fünfzig-Prozent-Marke hinaus. Darum ist nicht sicher, ob im ganzen Korpus mehr oder weniger als die Hälfte der Meldungen stimmt. Für eine Fehlerzahl fehlen die 70 Prozent Trefferquote. Ebenso darfst du bei den bezifferbaren Kategorien Getrennt- und Zusammenschreibung mit 72,5 Prozent Trefferquote (Bereich 63,9 bis 79,7) und Wortverwechslung mit 71,7 Prozent Trefferquote (Bereich 63,0 bis 79,0) die Zuverlässigkeit der Bestätigung nicht so darstellen, als würde eine Art deutlich häufiger bestätigt als die andere, da sich die jeweiligen Bereiche weit überschneiden; auch die Untergrenzen der Fehlerzahlen sind jeweils innerhalb ihrer methodischen Grenzen zu lesen. Zur Veranschaulichung eines echten Verstoßes bei der Getrennt- und Zusammenschreibung dient ein frei erfundenes Muster wie die fälschliche Getrenntschreibung „Teil nehmen“ statt der korrekten Form „teilnehmen“ in einem Beispielsatz wie „Viele Befragte wollten an der Erhebung Teil nehmen“. Wenn du vor der Abgabe deinen eigenen Text auf solche Verstöße durchsehen möchtest, kannst du über unsere Seite Rechtschreibfehler prüfen weitere Informationen abrufen oder den früheren Fehlerreport zu Abschlussarbeiten einsehen.
Wörter mit alter Schreibung in Abschlussarbeiten ab 2007
Neben den allgemeinen Kategorien hat korrektur.de im Korpus untersucht, in wie vielen Abschlussarbeiten noch Wörter nach alter Schreibung vorkommen. Wir werten erst ab 2007, weil die Übergangsfristen der Reform bis dahin ausgelaufen waren; ältere Arbeiten bleiben außerhalb der Wertung. In dieser Auswertung gibt die genannte Zahl jeweils an, in wie vielen verschiedenen Arbeiten des Korpus ab dem Erscheinungsjahr 2007 das betreffende Wort gefunden wurde. Sie nennt also ausdrücklich die Anzahl der betroffenen Arbeiten und nicht die Anzahl einzelner Textstellen, weshalb sich aus diesen Werten auch keine Gesamtfehlerzahl über alle Wörter hinweg bilden lässt.
Am häufigsten trat in den ab 2007 veröffentlichten Schriften des Korpus die veraltete Konjunktion „daß“ statt „dass“ auf, die in 37 Arbeiten nachgewiesen wurde. Dahinter folgen die Formen „muß“ statt „muss“ in 13 Arbeiten sowie „läßt“ statt „lässt“ in 12 Arbeiten. Auch Substantive und Verben mit altem Eszett nach kurzem Vokal wie „Einfluß“, „mußte“, „bewußt“, „müßte“, „Prozeß“, „Schloß“ und „Schlußfolgerungen“ wurden in mehreren Dokumenten des Korpus festgestellt, dazu die alte Schreibung „plaziert“ mit z statt tz.
| alte Schreibung | richtige Schreibung | Arbeiten |
|---|---|---|
| daß | dass | 37 |
| muß | muss | 13 |
| läßt | lässt | 12 |
| Einfluß | Einfluss | 6 |
| mußte | musste | 5 |
| bewußt | bewusst | 4 |
| müßte | müsste | 4 |
| Prozeß | Prozess | 3 |
| Schloß | Schloss | 3 |
| Schlußfolgerungen | Schlussfolgerungen | 3 |
| plaziert | platziert | 3 |
Einordnung: Was die Zahlen zeigen und was sich nicht ableiten lässt
Aus den Befunden dieser Rechtschreibfehler-Statistik lassen sich zwei gesicherte Erkenntnisse direkt ableiten. Erstens belegen die ausgewerteten Zufallsstichproben von je 120 Urteilen, dass die automatische Rechtschreib- und Grammatikprüfung LanguageTool selbst nach einem vorgeschalteten Filter gegen bekannte Fehlalarme bei der Rechtschreibung nur eine Trefferquote von 43,3 Prozent (Bereich 34,8 bis 52,3) und bei der Groß- und Kleinschreibung von 65,8 Prozent (Bereich 57,0 bis 73,7) erreicht. Automatische Meldungen in diesen beiden Kategorien sind in wissenschaftlichen Abschlussarbeiten also zu einem erheblichen Teil keine echten Fehler, weil das Programm in der Stichprobe zur Rechtschreibung in mehr als der Hälfte der gemeldeten Stellen falschlag. Zweitens zeigt die Untersuchung für das untersuchte Korpus aus 950 offenen Abschlussarbeiten, dass sich für die Getrennt- und Zusammenschreibung mit mindestens 0,24 Fehlern je 1.000 Wörter (Bereich 0,21 bis 0,26) und für Wortverwechslungen mit mindestens 0,040 Fehlern je 1.000 Wörter (Bereich 0,035 bis 0,044) belastbare Untergrenzen bestimmen lassen, weil dort die Trefferquoten mit 72,5 Prozent (Bereich 63,9 bis 79,7) und 71,7 Prozent (Bereich 63,0 bis 79,0) oberhalb des Grenzwerts von 70 Prozent liegen.
Demgegenüber stehen zwei Dinge, die du aus den vorliegenden Zahlen ausdrücklich nicht ableiten darfst. Zum einen erlauben die Ergebnisse keine Verallgemeinerung auf alle Studierenden oder auf sämtliche an Hochschulen eingereichten Arbeiten, denn das Gesamtkorpus besteht ausschließlich aus 950 offen zugänglichen Abschlussarbeiten aus 8 Hochschulquellen der Jahre 2003 bis 2026 und enthält keine Kundentexte. Zum anderen liefern die Daten keine Aussage über die tatsächliche Gesamtzahl aller Rechtschreibfehler in den untersuchten Dokumenten, sondern beziehen sich ausschließlich auf die durch LanguageTool und den nachgeschalteten Filter gemeldeten sowie in der Stichprobe beurteilten Stellen. Was das automatische Verfahren von vornherein nicht erkennt oder was der auf Genauigkeit getrimmte Filter verwirft, geht nicht in die Zahlen ein. Wer ergänzend den Vergleich verschiedener Abschlussarten betrachten möchte, findet in der Statistik zu Fehlern in Bachelorarbeiten weitere Daten.
Methodik: Korpus, Prüfverfahren und Grenzen der Auswertung
Grundlage dieser Untersuchung von korrektur.de (Stand November 2026) ist ein fest definiertes Korpus von 950 offenen Abschlussarbeiten aus den Entstehungsjahren 2003 bis 2026, die zusammen exakt 4.712.082 Wörter umfassen und aus 8 verschiedenen Hochschulquellen zusammengetragen wurden. Es handelt sich bei diesen untersuchten Dokumenten ausdrücklich um frei zugängliche Arbeiten und nicht um Kundentexte von korrektur.de. Im ersten Arbeitsschritt des mehrstufigen Prüfverfahrens durchliefen sämtliche Texte des Korpus die automatische Rechtschreib- und Grammatikprüfung LanguageTool, welche potenziell fehlerhafte Textstellen zunächst als Rohmeldungen erfasste. Anschließend sortierte ein nachgeschalteter Filter bekannte Fehlalarme systematisch aus diesen automatischen Meldungen aus, bevor die eigentliche statistische Auswertung der einzelnen Kategorien sowie die gesonderte Erfassung der ab dem Erscheinungsjahr 2007 nach dem Auslaufen der Übergangsfristen der Rechtschreibreform gewerteten alten Schreibungen wie beispielsweise daß statt dass in 37 Arbeiten oder muß statt muss in 13 Arbeiten erfolgte.
Um belastbar zu bestimmen, wie häufig die nach der Filterung verbleibenden Meldungen tatsächlich einen echten Regelverstoß darstellen, wurde für jede untersuchte Fehlerart eine eigene Zufallsstichprobe gezogen, die in der Regel 120 Textstellen je Art umfasste, und jede gezogene Textstelle einzeln Schritt für Schritt als echter Fehler oder als kein Fehler beurteilt. Ein nach festen Regeln arbeitendes KI-Modell fällte diese Einzelurteile für die jeweiligen Stichproben, woraufhin eine stichprobenartige Gegenprüfung der Bewertungen zur Qualitätssicherung stattfand; menschliche Lektorinnen oder Lektoren wirkten an dieser Einstufung der Zufallsstichproben ausdrücklich nicht mit. Wer sich unabhängig von dieser automatisierten Korpusstudie über eine professionelle Textprüfung für eigene Texte informieren möchte, findet auf der Übersichtsseite zu Lektorat und Korrekturlesen die entsprechenden Angebote. Aus den Einzelurteilen der jeweiligen Stichprobe entsteht die Trefferquote als prozentualer Anteil der bestätigten echten Fehler an allen geprüften Meldungen, statistisch abgesichert durch einen Wilson-Bereich mit 95 Prozent Sicherheit. Eine konkrete bereinigte Fehlerzahl weist korrektur.de in der Auswertung nur dann aus, wenn die ermittelte Trefferquote mindestens bei dem festgelegten Grenzwert von 70 Prozent liegt und zugleich mindestens 100 Einzelurteile für die betreffende Kategorie vorliegen, wie es bei der Getrennt- und Zusammenschreibung mit 72,5 Prozent (Bereich 63,9 bis 79,7 Prozent) sowie der Wortverwechslung mit 71,7 Prozent (Bereich 63,0 bis 79,0 Prozent) bei jeweils 120 Einzelurteilen der Fall ist. Wird diese methodische Schwelle hingegen wie bei der Rechtschreibung (43,3 Prozent, Bereich 34,8 bis 52,3 Prozent, Rang 3 von 7) oder der Groß- und Kleinschreibung (65,8 Prozent, Bereich 57,0 bis 73,7 Prozent, Rang 4 von 7) verfehlt, nennt der Bericht keine Fehlerzahl, sondern lediglich den Rang in der Reihenfolge der gefilterten Meldungen. Die bereinigte Fehlerzahl berechnet sich rechnerisch aus der Multiplikation der gefilterten Meldungen mit der jeweiligen Trefferquote und bildet methodisch immer eine Untergrenze, weil der eingesetzte Filter gezielt auf hohe Genauigkeit statt auf Vollständigkeit ausgelegt ist und sämtliche vom Verfahren überhaupt nicht gemeldete Verstöße in der Zählung fehlen.
Zitierhinweis für die Nutzung der Statistik als Quelle
Du darfst die Ergebnisse und Kennzahlen dieser Rechtschreibfehler-Statistik in wissenschaftlichen Arbeiten, journalistischen Beiträgen und sonstigen Veröffentlichungen mit Quellenangabe frei zitieren. Wichtig ist dabei, dass du immer sowohl korrektur.de als Quelle als auch den Stand vom 5. November 2026 vollständig mitnennst. Für dein Literatur- oder Quellenverzeichnis kannst du den folgenden fertigen Zitiertext direkt übernehmen:
korrektur.de (2026): Rechtschreibfehler in Abschlussarbeiten: Statistik. Eigene Auswertung von 950 offenen Abschlussarbeiten, Stand 5. November 2026. https://korrektur.de/rechtschreibfehler-statistik
So zitierst du diese Seite
Stand: 5. November 2026korrektur.de. (2026, 5. November). Rechtschreibfehler in Abschlussarbeiten: Statistik. korrektur.de. https://korrektur.de/rechtschreibfehler-statistik
„Rechtschreibfehler in Abschlussarbeiten: Statistik.“ korrektur.de, 5. Nov. 2026, korrektur.de/rechtschreibfehler-statistik. Zugriff 5. Nov. 2026.
korrektur.de (2026) Rechtschreibfehler in Abschlussarbeiten: Statistik. Verfügbar unter: https://korrektur.de/rechtschreibfehler-statistik (Zugriff: 5. November 2026).
korrektur.de. „Rechtschreibfehler in Abschlussarbeiten: Statistik.“ Zuletzt geändert 5. November 2026. https://korrektur.de/rechtschreibfehler-statistik.
korrektur.de. Rechtschreibfehler in Abschlussarbeiten: Statistik [online]. 2026 [Zugriff am 05.11.2026]. Verfügbar unter: https://korrektur.de/rechtschreibfehler-statistik
Quellen und Stand
- Eigene Auswertung korrektur.de (geprüft am 2026-11-05)