Zeichensetzung: Fehlerzahlen in offenen Abschlussarbeiten
 Fachlich geprüft von Benjamin Lohrer, Lektor bei korrektur.de · Stand: 5. November 2026
Bereinigte Untergrenze je 1.000 Wörter
Bereinigte Untergrenze je 1.000 Wörter
| Fehlerart | mindestens je 1.000 Wörter | Bereich | Trefferquote (Bereich) |
|---|---|---|---|
| Kommasetzung | 0,47 | 0,41 bis 0,52 | 70,8 % (62,2 bis 78,2) |
| übrige Zeichensetzung | 0,042 | 0,037 bis 0,046 | 75,0 % (66,6 bis 81,9) |
Häufigste Regelgruppen bei den Meldungen, nur Reihenfolge
| Rang | Kommasetzung | übrige Zeichensetzung |
|---|---|---|
| 1 | Komma zwischen Haupt- und Nebensatz | Zahl plus „jährig“ ohne Bindestrich (etwa 45jährig) |
| 2 | Komma bei Infinitivgruppen | Apostroph beim Plural |
| 3 | überflüssiges Komma | Zeichensetzung bei direkter Rede |
| 4 | Komma vor dem Relativsatz | Abkürzung ohne Punkte |
Zeichensetzungsfehler: Komma und übrige Zeichensetzung
In offenen Abschlussarbeiten treten nach der eigenen Auswertung von korrektur.de (Stand 5. November 2026) auf Basis von 950 Arbeiten je 1.000 Wörter bereinigt mindestens 0,47 Fehler (Bereich 0,41 bis 0,52) bei der Kommasetzung sowie mindestens 0,042 Fehler (Bereich 0,037 bis 0,046) bei der übrigen Zeichensetzung auf. Das untersuchte Textkorpus umfasst insgesamt 4.712.082 Wörter aus acht verschiedenen Hochschulquellen und stammt aus den Entstehungsjahren 2003 bis 2026. Kundentexte sind in dieser Datengrundlage nicht enthalten. Auf den gesamten Textbestand bezogen entspricht das bereinigt mindestens etwa 2.225 Kommastellen (Bereich 1.952 bis 2.457) und mindestens etwa 199 Stellen der übrigen Zeichensetzung (Bereich 176 bis 217). Beide Kennzahlen bezeichnen eine methodische Untergrenze, weil der eingesetzte Filter nach den Meldungen von LanguageTool auf Genauigkeit statt auf Vollständigkeit ausgerichtet ist.
Kurzantwort zur Zeichensetzungsfehler-Statistik
Laut der eigenen Auswertung von korrektur.de (Stand 5. November 2026) an einem Korpus aus 950 offenen Abschlussarbeiten mit insgesamt 4.712.082 Wörtern treten je 1.000 Wörter bereinigt mindestens 0,47 Fehler (Bereich 0,41 bis 0,52) bei der Kommasetzung und mindestens 0,042 Fehler (Bereich 0,037 bis 0,046) bei der übrigen Zeichensetzung auf. Im gesamten untersuchten Textbestand aus acht verschiedenen Hochschulquellen der Entstehungsjahre 2003 bis 2026 entspricht dies mindestens etwa 2.225 bereinigten Kommastellen (Bereich 1.952 bis 2.457) sowie mindestens etwa 199 bereinigten Stellen der übrigen Zeichensetzung (Bereich 176 bis 217). Beide Kennzahlen bilden ausschließlich eine methodische Untergrenze für die untersuchten offenen Arbeiten ohne Kundentexte ab, weil der eingesetzte Filter gezielt auf Genauigkeit statt auf Vollständigkeit ausgerichtet ist und die Rohmeldungen vor der Bereinigung keinen Anteil fehlerhafter Arbeiten ausdrücken.
Vor dem Bereinigungsschritt trat in 78,7 Prozent der 950 untersuchten Abschlussarbeiten mindestens eine Kommameldung und in 15,5 Prozent mindestens eine Meldung zur sonstigen Zeichensetzung auf. Für die Kommasetzung ergab die Auswertung von 120 Einzelurteilen eine Trefferquote von 70,8 Prozent (Bereich 62,2 bis 78,2), während die übrige Zeichensetzung bei ebenfalls 120 geprüften Urteilen eine Trefferquote von 75,0 Prozent (Bereich 66,6 bis 81,9) erreichte. Im mehrstufigen Verfahren meldet zunächst die Prüfsoftware LanguageTool auffällige Textstellen, bevor ein nachgeschalteter Filter bekannte Fehlalarme zuverlässig entfernt. Ein nach festen Vorgaben arbeitendes KI-Modell stufte die gezogenen Zufallsstichproben anschließend Stelle für Stelle als echten Fehler oder als keinen Fehler ein, woraufhin diese Einstufungen stichprobenartig gegengeprüft wurden. Menschliche Lektorinnen oder Lektoren wirkten an dieser Beurteilung nicht mit. Rechnerisch ergibt sich die bereinigte Mindestzahl aus den gefilterten Meldungen multipliziert mit der jeweiligen Trefferquote samt statistischem Wilson-Bereich bei 95 Prozent Sicherheit; vom Verfahren unentdeckte Verstöße bleiben in der Zählung unberücksichtigt.
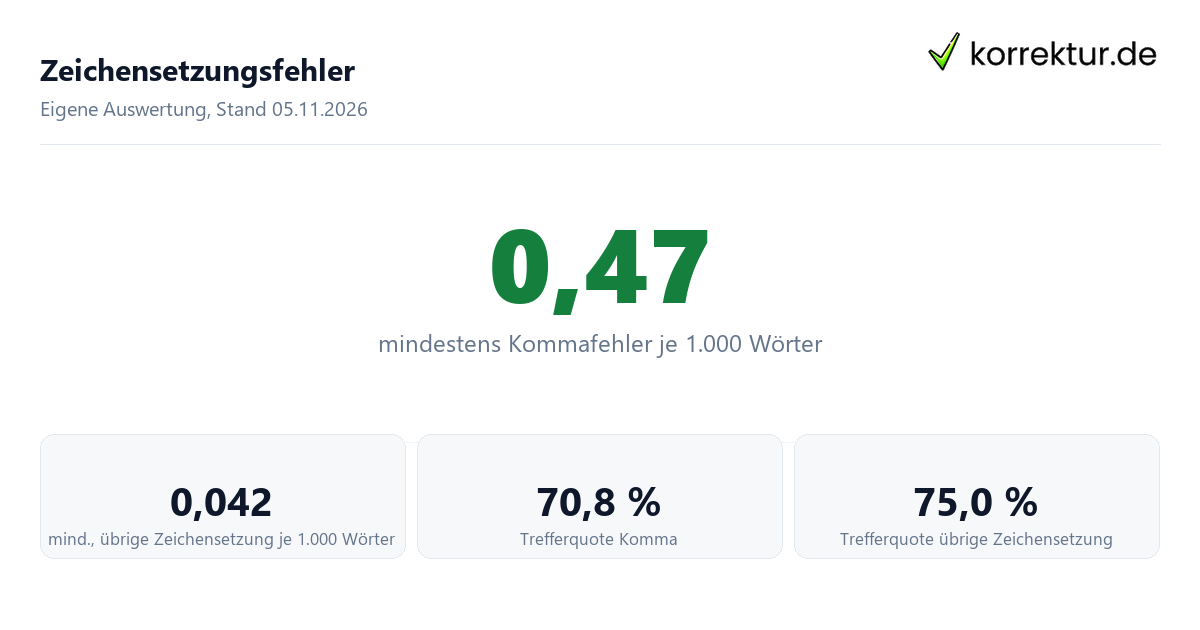
Bereinigte Zahlen und Trefferquote im Korpus
Die Zeichensetzungsfehler-Statistik unterscheidet innerhalb des untersuchten Gesamtkorpus aus 950 offenen Abschlussarbeiten zwischen der Kommasetzung und der übrigen Zeichensetzung. Das ausgewertete Textkorpus umfasst insgesamt 4.712.082 Wörter aus acht verschiedenen Hochschulquellen, deckt die Entstehungsjahre 2003 bis 2026 ab und schließt ausdrücklich keine Kundentexte ein. Bei der Kommasetzung ergibt die Auswertung je 1.000 Wörter einen bereinigten Wert von mindestens 0,47 Fehlern (Bereich 0,41 bis 0,52). Auf den gesamten Wortbestand des untersuchten Korpus bezogen entspricht dieser Befund mindestens etwa 2.225 bestätigten Stellen (Bereich 1.952 bis 2.457), ermittelt über eine bestätigte Trefferquote von 70,8 Prozent (Bereich 62,2 bis 78,2) auf Grundlage von 120 Einzelurteilen. Für die übrige Zeichensetzung außerhalb des Kommas liegt der bereinigte Wert je 1.000 Wörter bei mindestens 0,042 Fehlern (Bereich 0,037 bis 0,046). Im gesamten Textbestand der untersuchten Abschlussarbeiten sind das mindestens etwa 199 bestätigte Stellen (Bereich 176 bis 217), was auf einer ermittelten Trefferquote von 75,0 Prozent (Bereich 66,6 bis 81,9) bei ebenfalls 120 geprüften Urteilen beruht. Beide übergeordneten Fehlerarten überschreiten damit den festgelegten methodischen Grenzwert von mindestens 70 Prozent Trefferquote bei mindestens 100 vorliegenden Urteilen, ab dem in der Untersuchung eine bereinigte Zahl statt einer bloßen Rangfolge ausgewiesen wird.
| Fehlerart | Mindestens je 1.000 Wörter | Bereich | Trefferquote |
|---|---|---|---|
| Kommasetzung | mindestens 0,47 | 0,41 bis 0,52 | 70,8 Prozent (Bereich 62,2 bis 78,2) |
| Übrige Zeichensetzung | mindestens 0,042 | 0,037 bis 0,046 | 75,0 Prozent (Bereich 66,6 bis 81,9) |
Beide bereinigten Kennzahlen zur Zeichensetzung stellen ausdrücklich eine methodische Untergrenze dar, weil der im Prüfverfahren eingesetzte Filter nach den Meldungen der Prüfsoftware LanguageTool gezielt auf hohe Genauigkeit statt auf Vollständigkeit ausgerichtet ist und vom Verfahren nicht gemeldete Verstöße in der Zählung fehlen. Die bereinigte Anzahl errechnet sich jeweils aus den gefilterten Meldungen multipliziert mit der in der Zufallsstichprobe bestimmten Trefferquote, für die ein statistischer Wilson-Bereich mit 95 Prozent Sicherheit angegeben wird. Die Einzelurteile der gezogenen Stichprobe stammen von einem KI-Modell, das nach festen Vorgaben arbeitete, und wurden anschließend stichprobenartig gegengeprüft, wobei keine menschlichen Lektorinnen oder Lektoren zum Einsatz kamen. Vor diesem Bereinigungsschritt registrierte das Verfahren bei 78,7 Prozent der 950 untersuchten Arbeiten mindestens eine gemeldete Kommastelle sowie bei 15,5 Prozent der Arbeiten mindestens eine gemeldete Stelle zur übrigen Zeichensetzung. Diese beiden Prozentwerte bilden ausschließlich die Häufigkeit einer Meldung vor der Bereinigung ab und dürfen keinesfalls als Anteil fehlerhafter Abschlussarbeiten gedeutet werden, da sich ein Teil der Meldungen in der Stichprobenprüfung als kein echter Fehler erwies. Bei der sonstigen Zeichensetzung zählt zudem eine Zahl plus „jährig“ ohne Bindestrich nach Paragraf 40 des amtlichen Regelwerks als Fehler, ohne dessen Berücksichtigung die Trefferquote bei 65 statt 75 Prozent läge. Ergänzend zu dieser Auswertung stehen als weitere Übersichten auch eine Statistik zu Rechtschreibfehlern sowie eine Statistik zu Grammatikfehlern bereit.
Rangfolge der Regelgruppen bei den gefilterten Meldungen
Innerhalb beider untersuchten Kategorien zeigt die Auswertung für das aus 950 offenen Abschlussarbeiten bestehende Korpus, welche Regelgruppen bei den gefilterten Meldungen am stärksten vertreten sind. Diese Reihenfolge beschreibt ausschließlich die nach dem Einsatz von LanguageTool und dem Fehlalarm-Filter verbleibenden Meldungen und stellt ausdrücklich keine bestätigte Fehlerzahl dar. Im Status einer bloßen Rangfolge werden weder eine konkrete Fehlerzahl noch eine Meldungszahl oder ein aus Trefferquote und Meldungen berechneter Wert ausgewiesen. Gemäß dem methodischen Grenzwert nennt die Untersuchung eine Zahl nur dann, wenn mindestens 100 Urteile vorliegen und die Trefferquote mindestens 70 Prozent erreicht. Da die Zufallsstichprobe von jeweils 120 Urteilen sowie die Trefferquote von 70,8 Prozent (Bereich 62,2 bis 78,2) für das Komma beziehungsweise 75,0 Prozent (Bereich 66,6 bis 81,9) für die sonstige Zeichensetzung nur für die beiden übergeordneten Fehlerarten insgesamt bestimmt wurden, erfolgt für einzelne Regelgruppen keine numerische Ausweisung. Bei der sonstigen Zeichensetzung gilt eine Verbindung aus Zahl und „jährig“ ohne Bindestrich laut Paragraf 40 des amtlichen Regelwerks als Fehler; würde diese Schreibweise anders gewertet, fiele die entsprechende Trefferquote von 75 auf 65 Prozent und läge somit unterhalb der erforderlichen Grenze von 70 Prozent.
| Rang | Kommasetzung (gefilterte Meldungen) | Übrige Zeichensetzung (gefilterte Meldungen) |
|---|---|---|
| Rang 1 | Komma zwischen Haupt- und Nebensatz | Zahl plus „jährig“ ohne Bindestrich (etwa 45jährig) |
| Rang 2 | Komma bei Infinitivgruppen | Apostroph beim Plural |
| Rang 3 | überflüssiges Komma | Zeichensetzung bei direkter Rede |
| Rang 4 | Komma vor dem Relativsatz | Abkürzung ohne Punkte |
Zur Veranschaulichung dienen frei erfundene Muster ohne Bezug auf Texte des Korpus, beispielsweise für ein fehlendes Komma bei einer Infinitivgruppe die fehlerhafte Schreibweise „Er versuchte die Messung zu wiederholen“ gegenüber der korrekten Fassung „Er versuchte, die Messung zu wiederholen“ oder bei der sonstigen Zeichensetzung die Schreibweise „45jährig“ ohne Bindestrich. Wenn du für deine eigene Arbeit die Komma-Regeln nachlesen oder gezielt deine Zeichensetzung prüfen möchtest, findest du dazu weiterführende Übersichten.
Wertung von Verbindungen mit „jährig“ nach Paragraf 40
Ein methodischer Hinweis betrifft die Einordnung von Verbindungen aus einer Zahl plus „jährig“ ohne Bindestrich (etwa 45jährig als Muster). Nach Paragraf 40 der amtlichen Regelung zählt eine solche Verbindung aus Ziffer und „jährig“ ohne Bindestrich als Fehler. In der Auswertung des Korpus bildet genau diese Kategorie auf Rang 1 die häufigste Regelgruppe innerhalb der übrigen Zeichensetzung.
Diese Wertung entscheidet unmittelbar darüber, ob für die übrige Zeichensetzung überhaupt eine bereinigte Fehlerzahl ausgewiesen wird. Ohne die Einstufung von Schreibungen wie 45jährig als Fehler läge die Trefferquote in der Stichprobe der übrigen Zeichensetzung bei 65 Prozent statt bei 75,0 Prozent (Bereich 66,6 bis 81,9). Damit bliebe die Quote unter dem methodischen Grenzwert von 70 Prozent, unterhalb dessen anstelle einer Fehlerzahl lediglich eine Rangfolge berichtet wird.
Einordnung der Ergebnisse und Grenzen der Aussage
Aus den Daten des Korpus lassen sich zwei Sachaussagen begründet ableiten. Erstens kommen bestätigte Kommafehler mit bereinigt mindestens 0,47 Fehlern je 1.000 Wörter (Bereich 0,41 bis 0,52) in den untersuchten Arbeiten deutlich zahlreicher vor als bestätigte Fehler der übrigen Zeichensetzung mit mindestens 0,042 Fehlern je 1.000 Wörter (Bereich 0,037 bis 0,046). Zweitens belegt die Trefferquote von 70,8 Prozent (Bereich 62,2 bis 78,2) beim Komma und 75,0 Prozent (Bereich 66,6 bis 81,9) bei der übrigen Zeichensetzung, dass selbst gefilterte Meldungen einer automatischen Prüfung noch Fehlalarme enthalten.
Zwei weitergehende Annahmen lassen sich dagegen nicht aus der Auswertung ableiten. Erstens sind keine Rückschlüsse auf alle Studierenden oder auf Kundentexte zulässig, weil das Korpus ausschließlich 950 offene Abschlussarbeiten aus acht Hochschulquellen umfasst. Zweitens gilt die Aussage ausschließlich für die vom Verfahren gemeldeten und in der Stichprobe beurteilten Stellen, nicht für unentdeckte Zeichensetzungsfehler im Text. Ergänzende Informationen bieten der frühere Fehlerreport zu Abschlussarbeiten einer kleineren Auswahl sowie der Überblick zu Lektorat und Korrekturlesen.
Methodik der Auswertung und Grenzen des Verfahrens
Grundlage der Untersuchung ist ein Korpus aus 950 offenen Abschlussarbeiten mit insgesamt 4.712.082 Wörtern aus den Entstehungsjahren 2003 bis 2026, zusammengestellt aus acht Hochschulquellen; es sind ausdrücklich keine Kundentexte enthalten. Im Prüfverfahren meldet zunächst die Rechtschreib- und Grammatikprüfung LanguageTool verdächtige Textstellen, bevor ein Filter bekannte Fehlalarme entfernt. Anschließend wurde je Fehlerart eine Zufallsstichprobe von 120 gemeldeten Stellen gezogen und Stelle für Stelle im Einzelurteil als echter Fehler oder als kein Fehler beurteilt. Diese Urteile stammen von einem KI-Modell, das unter festen Regeln arbeitete, und wurden stichprobenartig gegengeprüft; menschliche Lektorinnen oder Lektoren wirkten daran nicht mit.
Aus den Einzelurteilen ergibt sich die Trefferquote als Anteil echter Fehler an den gefilterten Meldungen samt einem Wilson-Bereich für 95 Prozent Sicherheit (Stand November 2026). Eine bereinigte Zahl aus Meldungen mal Trefferquote wird nur genannt, wenn mindestens 100 Urteile vorliegen und die Trefferquote mindestens 70 Prozent erreicht; sonst wird lediglich eine Rangfolge veröffentlicht. Bei der übrigen Zeichensetzung sichert erst die Wertung einer Zahl plus „jährig“ ohne Bindestrich (etwa 45jährig) nach Paragraf 40 der amtlichen Regelung als Fehler das Überschreiten des Grenzwerts, da die Trefferquote ohne diese Wertung bei 65 statt 75 Prozent und folglich unter dem Grenzwert von 70 Prozent läge. Da der Filter auf Genauigkeit statt auf Vollständigkeit zielt und nicht gemeldete Verstöße fehlen, bilden die bereinigten Fehlerzahlen methodisch Untergrenzen.
Quellenangabe und Zitiertext für die Auswertung
Die Zahlen dieser Auswertung dürfen mit Quellenangabe frei zitiert werden; bei der Übernahme sind korrektur.de als Quelle sowie der Stand vom 5. November 2026 stets zusammen mit den Werten mitzunennen. Nutze für Quellenverzeichnisse und Belege den folgenden fertigen Zitiertext:
korrektur.de (2026): Zeichensetzungsfehler in Abschlussarbeiten: Statistik. Eigene Auswertung von 950 offenen Abschlussarbeiten, Stand 5. November 2026. https://korrektur.de/zeichensetzungsfehler-statistik
So zitierst du diese Seite
Stand: 5. November 2026korrektur.de. (2026, 5. November). Zeichensetzungsfehler in Abschlussarbeiten: Statistik. korrektur.de. https://korrektur.de/zeichensetzungsfehler-statistik
„Zeichensetzungsfehler in Abschlussarbeiten: Statistik.“ korrektur.de, 5. Nov. 2026, korrektur.de/zeichensetzungsfehler-statistik. Zugriff 5. Nov. 2026.
korrektur.de (2026) Zeichensetzungsfehler in Abschlussarbeiten: Statistik. Verfügbar unter: https://korrektur.de/zeichensetzungsfehler-statistik (Zugriff: 5. November 2026).
korrektur.de. „Zeichensetzungsfehler in Abschlussarbeiten: Statistik.“ Zuletzt geändert 5. November 2026. https://korrektur.de/zeichensetzungsfehler-statistik.
korrektur.de. Zeichensetzungsfehler in Abschlussarbeiten: Statistik [online]. 2026 [Zugriff am 05.11.2026]. Verfügbar unter: https://korrektur.de/zeichensetzungsfehler-statistik
Quellen und Stand
- Eigene Auswertung korrektur.de (geprüft am 2026-11-05)