Grammatik: Trefferquote und Rangfolge in Abschlussarbeiten
 Fachlich geprüft von Benjamin Lohrer, Lektor bei korrektur.de · Stand: 5. November 2026
Trefferquote je Fehlerart in Prozent (Grenzwert 70)
Grammatik: Verlässlichkeit der Meldungen
| Kennwert | Wert |
|---|---|
| Trefferquote | 67,5 % |
| Bereich (95 Prozent) | 58,7 bis 75,2 % |
| Urteile | 120 |
| Grenzwert | 70 % |
Häufigste Regelgruppen bei den Meldungen, nur Reihenfolge
| Rang | Regelgruppe |
|---|---|
| 1 | Übereinstimmung von Artikel, Adjektiv und Nomen |
| 2 | Präposition und der dazu passende Fall |
Grammatikfehler: Warum es keine Fehlerzahl gibt
In der eigenen Auswertung von korrektur.de von 950 offenen Abschlussarbeiten mit Stand 5. November 2026 erreicht die Grammatikprüfung nach Filterung eine Trefferquote von 67,5 Prozent (Bereich 58,7 bis 75,2), weshalb diese Kategorie den Status einer Rangfolge erhält und ohne konkrete Fehlerzahl bleibt. Bei den gefilterten Meldungen aller sieben untersuchten Kategorien belegt die Grammatik zwar den ersten Platz, doch weil die Treffsicherheit knapp unter dem methodischen Grenzwert von 70 Prozent liegt, veröffentlicht die Untersuchung weder eine Meldungszahl noch eine bereinigte Fehlerzahl. Du siehst hier die genauen Kennwerte der Stichprobe, die Rangfolge der häufigsten Regelgruppen sowie die methodischen Grenzen des Verfahrens.
Kurzantwort zur Grammatik in Abschlussarbeiten
Nach der eigenen Auswertung von korrektur.de auf Basis von 950 offenen Abschlussarbeiten mit Stand 5. November 2026 erreicht die Kategorie Grammatik bei den beurteilten Stellen eine Trefferquote von 67,5 Prozent (Bereich 58,7 bis 75,2) und erhält deshalb den Status einer Rangfolge ohne ausgewiesene Fehlerzahl. Als wichtigster Zusatzbefund belegt die Grammatik unter den sieben untersuchten Fehlerarten bei den gefilterten Meldungen den Rang 1 von 7, wobei die Übereinstimmung von Artikel, Adjektiv und Nomen auf Rang 1 vor der Präposition und dem dazu passenden Fall auf Rang 2 steht. Die Grenze dieser Aussage liegt darin, dass die erreichte Trefferquote knapp den festgelegten Grenzwert von 70 Prozent verfehlt, weshalb jede hochgerechnete Fehlerzahl geraten wäre und sich alle Ergebnisse ausschließlich auf die gemeldeten sowie beurteilten Stellen der untersuchten offenen Hochschularbeiten beziehen.
Wenn du diese Grammatikfehler-Statistik mit früheren Erhebungen vergleichen möchtest, bietet dir der Fehlerreport zu Abschlussarbeiten einen Einblick in eine ältere Untersuchung auf kleinerer Datenbasis. In der aktuellen Erhebung aus dem November 2026 umfasst das Gesamtkorpus 4.712.082 Wörter aus den Entstehungsjahren 2003 bis 2026, die aus 8 Hochschulquellen stammen. Es handelt sich dabei ausdrücklich um keine Kundentexte.
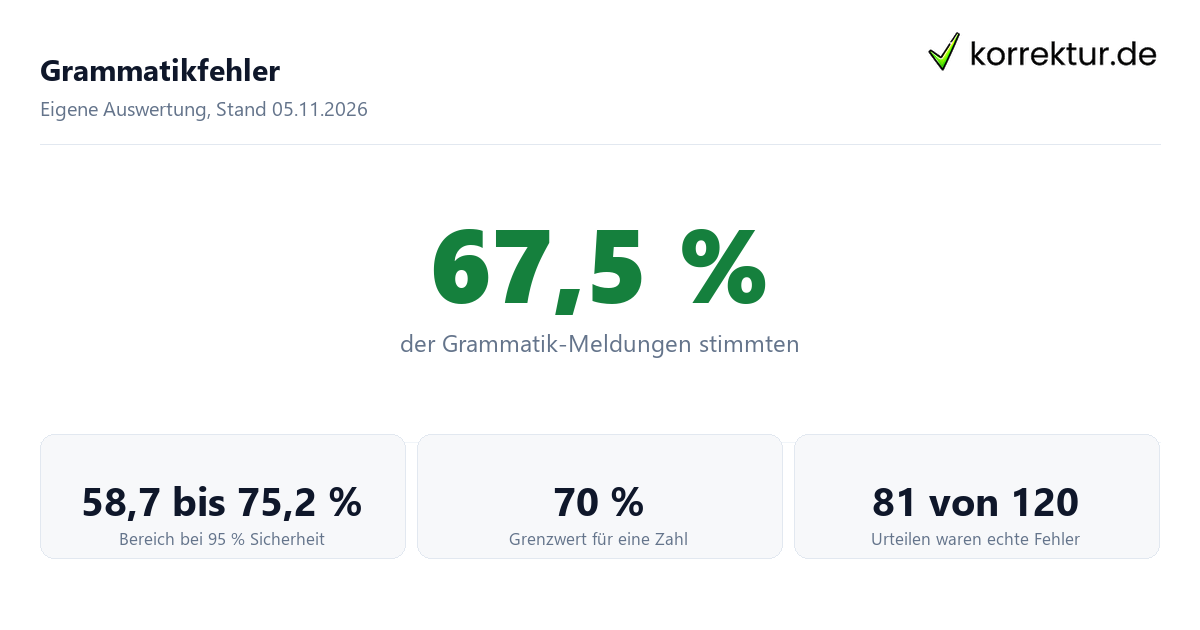
Trefferquote der Grammatikmeldungen im Überblick
In der geprüften Zufallsstichprobe für den Bereich Grammatik liegt die Trefferquote bei 67,5 Prozent (Bereich 58,7 bis 75,2). Konkret waren 81 von 120 einzeln beurteilten Meldungen echte Fehler, während die verbleibenden 39 Meldungen keinen tatsächlichen Verstoß darstellten. Dieses Ergebnis liegt knapp unter dem methodischen Grenzwert von 70 Prozent, den die Auswertung für die Nennung einer konkreten Fehlerzahl voraussetzt. Wer eine eigene Arbeit mit einem automatischen Grammatikcheck untersucht, stößt in den ungeprüften Meldungen daher auch nach einer ersten Vorfilterung auf Stellen, die grammatisch zulässig sind.
| Kennwert | Wert |
|---|---|
| Trefferquote | 67,5 Prozent |
| Bereich (Wilson-Bereich, 95 Prozent Sicherheit) | 58,7 bis 75,2 Prozent |
| Zahl der Urteile | 120 beurteilte Meldungen (davon 81 echte Fehler) |
| Grenzwert für eine Fehlerzahl | 70 Prozent bei mindestens 100 Urteilen |
| Status der Kategorie | Rangfolge |
| Rang bei den gefilterten Meldungen | 1 von 7 |
Der ausgewiesene Bereich von 58,7 bis 75,2 Prozent gibt mit 95 Prozent Sicherheit an, in welchem Rahmen sich der Anteil echter Fehler unter den gefilterten Meldungen des gesamten untersuchten Materials bewegt. Weil das untere Ende dieses Bereichs deutlich unter der Schwelle von 70 Prozent liegt und auch der Mittelwert der Stichprobe diese Marke nicht erreicht, weist die Untersuchung für die Grammatik keine bereinigte Anzahl an Fehlern aus.
Häufigste Regelgruppen nach gefilterten Meldungen
Innerhalb der Kategorie Grammatik lassen sich die häufigsten Auslöser ausschließlich als Rangfolge und ohne jede Zahl darstellen. Auf Rang 1 steht die Übereinstimmung von Artikel, Adjektiv und Nomen. Auf Rang 2 folgen die Präposition und der dazu passende Fall. Nach diesen beiden führenden Bereichen schließen sich viele kleinere Gruppen an, die in der Auswertung nicht einzeln benannt werden. Wichtig für das Verständnis dieser Übersicht ist eine strikte Trennung: Die dargestellte Reihenfolge beschreibt allein die Zahl der gefilterten Meldungen im untersuchten Material und sagt nichts über die Zahl echter Fehler aus.
| Kennwert | Wert |
|---|---|
| Rang 1 der gefilterten Meldungen | Übereinstimmung von Artikel, Adjektiv und Nomen |
| Rang 2 der gefilterten Meldungen | Präposition und der dazu passende Fall |
| Weitere Plätze | Viele kleinere Gruppen ohne Einzelnennung |
| Aussagekraft der Reihenfolge | Beschreibt nur die Zahl der gefilterten Meldungen, nicht die Zahl echter Fehler |
Um die beiden führenden Regelgruppen anschaulich zu machen, helfen frei erfundene Muster, die nicht aus dem Korpus stammen. Ein frei erfundenes Muster für Rang 1 ist der Satzbau ein interessanter Ergebnis der Studie, bei dem das sächliche Nomen und das vorangestellte Adjektiv nicht übereinstimmen. Ein ebenso frei erfundenes Muster für Rang 2 ist die Formulierung während dem gesamten Semester, in der nach der Präposition ein abweichender Fall steht. Solche Konstruktionen lösen bei der automatischen Prüfung Meldungen aus, müssen aber im Einzelfall immer daraufhin beurteilt werden, ob im jeweiligen Satz tatsächlich ein Verstoß vorliegt. Anders als in dieser reinen Rangübersicht erfährst du in der Statistik zu Rechtschreibfehlern sowie in der Statistik zu Zeichensetzungsfehlern, wie die Auswertung mit anderen Kategorien des gleichen Korpus verfährt.
Warum diese Statistik keine Fehlerzahl für Grammatik nennt
Der Grund für das Fehlen einer konkreten Mengenangabe in dieser Statistik liegt in den festen Qualitätskriterien der Untersuchung: Unterschreitet der ermittelte Genauigkeitswert die Schwelle von 70 Prozent oder liegen in der Stichprobe weniger als 100 Einzelbewertungen vor, bleibt eine Kategorie ohne Mengenwert. Trifft eines dieser beiden Ausschlusskriterien zu, ist für die jeweilige Kategorie nur die Reihenfolge belastbar, während eine ausgewiesene Fehlerzahl geraten wäre. Bei der Grammatik liegt zwar eine ausreichende Zahl von 120 Einzelurteilen vor, doch die ermittelte Trefferquote von 67,5 Prozent (Bereich 58,7 bis 75,2) unterschreitet die geforderte Schwelle von 70 Prozent. Aus diesem Grund wird auf dieser Seite ausdrücklich weder eine Meldungszahl noch eine aus Trefferquote und Meldungen hochgerechnete Fehlerzahl genannt.
Dieses Vorgehen verhindert, dass unbereinigte Rohdaten oder zu unsichere Schätzwerte als scheinbar exakte Fakten verbreitet werden. Vor der Bereinigung durch Einzelurteile liegen im Verfahren lediglich gefilterte Meldungen und eine entsprechende Meldungsdichte vor. Als Fehler gilt in der Auswertung jedoch nur, was in der Überprüfung als echter Fehler bestätigt wurde. Damit in einer künftigen Untersuchung auch für die Kategorie Grammatik eine konkrete Zahl möglich wird, fehlt ein klar benennbarer Baustein: Nötig ist eine höhere Trefferquote nach weiterer Filterung der automatischen Meldungen. Erst wenn verbesserte Filterregeln die bekannten Fehlalarme so weit reduzieren, dass mindestens 70 Prozent der geprüften Stellen bei mindestens 100 Urteilen echte Verstöße sind, lässt sich eine bereinigte Zahl seriös als Untergrenze berechnen. In der vorliegenden Stichprobe von 120 untersuchten Grammatikstellen wurden genau 81 Meldungen als echte Verstöße bestätigt, weshalb zum Erreichen der 70-Prozent-Marke nur wenige zusätzliche Treffer nach einer schärferen Vorfilterung fehlen. Ergänzend zeigt dir die Statistik zu Fehlern in Bachelorarbeiten, wie die Auswertung Abschlussarbeiten nach unterschiedlichen Studienabschlüssen betrachtet.
Einordnung: Was die Daten zeigen und was nicht
Für die richtige Einordnung der Ergebnisse musst du genau zwischen belegten Befunden und unzulässigen Verallgemeinerungen trennen. Es gibt zwei zentrale Punkte, die du direkt aus den Daten ableiten darfst. Erstens lässt sich ableiten, dass die Kategorie Grammatik unter allen sieben untersuchten Arten die meisten gefilterten Meldungen erzeugt und dort auf Rang 1 von 7 steht; begründet ist dies durch die direkte Auszählung der gefilterten Meldungen nach dem Durchlauf der Prüfung im Gesamtkorpus. Zweitens darfst du ableiten, dass in der geprüften Zufallsstichprobe von 120 Grammatikmeldungen mit 81 echten Fehlern zwar die Mehrheit der gemeldeten Stellen zutraf, die Trefferquote von 67,5 Prozent (Bereich 58,7 bis 75,2) aber wegen des verfehlten Grenzwerts von 70 Prozent nicht für eine verlässliche Hochrechnung auf eine Gesamtfehlerzahl ausreicht.
Demgegenüber stehen zwei Dinge, die du aus dieser Auswertung ausdrücklich nicht ableiten darfst. Erstens erlaubt die Untersuchung keine Aussage über alle Studierenden oder über sämtliche an Hochschulen verfassten Arbeiten; das Korpus umfasst ausschließlich 950 offene Abschlussarbeiten aus 8 Hochschulquellen und enthält keine Kundentexte. Zweitens darfst du aus den Daten nicht ableiten, wie häufig Grammatikfehler in den untersuchten Texten insgesamt sind oder dass ein bestimmter Prozentsatz der Arbeiten fehlerhaft sei. Die Aussage der Daten bezieht sich ausschließlich auf die vom System gemeldeten und in der Stichprobe beurteilten Stellen. Was die automatische Prüfung gar nicht erst als Verdachtsfall meldet, bleibt im Verfahren unsichtbar, und die unbereinigte Zahl der Arbeiten mit mindestens einer Meldung ist keine belastbare Kernzahl.
Methodik, Korpus und Grenzen des Verfahrens
Die Methodik der Untersuchung zum Stand November 2026 stützt sich auf ein fest definiertes Gesamtkorpus: Ausgewertet wurden 950 offene Abschlussarbeiten mit insgesamt 4.712.082 Wörtern aus den Entstehungsjahren 2003 bis 2026, die aus 8 Hochschulquellen stammen. Es sind ausdrücklich keine Kundentexte in diese Datenbasis eingeflossen. Für die technische Erfassung durchliefen die Texte des Korpus die Rechtschreib- und Grammatikprüfung LanguageTool, die auffällige Textstellen meldet. Im nächsten Schritt entfernte ein eigens eingesetzter Filter bekannte Fehlalarme aus den Rohmeldungen, um die Meldungsdichte von offensichtlichen Scheinproblemen der Rechtschreibung und Grammatik zu bereinigen.
Anschließend wurde je Fehlerart eine Zufallsstichprobe gezogen, die bei der Grammatik 120 gemeldete Stellen umfasste. Jede dieser gezogenen Stellen erhielt ein Einzelurteil darüber, ob ein echter Fehler oder kein Fehler vorliegt. Ein an klare Vorgaben gebundenes KI-Modell fällte diese Entscheidungen für jede einzelne Textstelle, woraufhin eine stichprobenartige Gegenprüfung der Bewertungen stattfand. Es waren dabei keine menschlichen Lektorinnen oder Lektoren im Einsatz; allgemeine Informationen zu menschlicher Textarbeit findest du auf den Übersichtsseiten zu Lektorat und Korrekturlesen. Aus den Einzelurteilen der Stichprobe errechnet sich die Trefferquote samt einem Wilson-Bereich für 95 Prozent Sicherheit. Eine bereinigte Zahl weist die Studie nur dann aus, wenn die erreichte Trefferquote mindestens 70 Prozent beträgt und zugleich wenigstens 100 Einzelurteile vorliegen. Liegt ein Wert unter dieser Schwelle, vergibt die Auswertung statt einer Zahl lediglich den Status einer Rangfolge, wie es bei der Grammatik mit Platz 1 von 7 unter den gefilterten Meldungen sowie den beiden führenden Regelgruppen zur Übereinstimmung von Artikel, Adjektiv und Nomen und zur Präposition mit passendem Fall geschieht. In Kategorien mit Status Zahl ergibt sich der bereinigte Wert aus den gefilterten Meldungen multipliziert mit der Trefferquote. Dabei gelten klare methodische Grenzen: Weil der eingesetzte Filter auf Genauigkeit statt auf Vollständigkeit zielt und nicht gemeldete Verstöße unerkannt bleiben, sind bereinigte Zahlen immer als mindestens geltende Werte beziehungsweise als Untergrenzen zu verstehen.
So zitierst du diese Auswertung korrekt
Du darfst alle Kennwerte, die Trefferquote samt Bereich sowie die Rangfolge dieser Untersuchung in eigenen Artikeln, Studien oder Hausarbeiten mit Quellenangabe frei zitieren. Wichtig ist dabei, dass du korrektur.de als Quelle sowie das untersuchte Korpus und den Stand 5. November 2026 bei jeder Nennung vollständig mit angibst. Nutze für deine Quellenangabe oder dein Literaturverzeichnis direkt den folgenden fertigen Zitiertext:
korrektur.de (2026): Grammatikfehler in Abschlussarbeiten: Statistik. Eigene Auswertung von 950 offenen Abschlussarbeiten, Stand 5. November 2026. https://korrektur.de/grammatikfehler-statistik
Überprüfe beim Übernehmen der Angaben in deinen Text, dass du die Trefferquote von 67,5 Prozent (Bereich 58,7 bis 75,2) ausschließlich auf die gefilterten und beurteilten Grammatikmeldungen beziehst und sie nicht als Anteil fehlerhafter Arbeiten darstellst.
So zitierst du diese Seite
Stand: 5. November 2026korrektur.de. (2026, 5. November). Grammatikfehler in Abschlussarbeiten: Statistik. korrektur.de. https://korrektur.de/grammatikfehler-statistik
„Grammatikfehler in Abschlussarbeiten: Statistik.“ korrektur.de, 5. Nov. 2026, korrektur.de/grammatikfehler-statistik. Zugriff 5. Nov. 2026.
korrektur.de (2026) Grammatikfehler in Abschlussarbeiten: Statistik. Verfügbar unter: https://korrektur.de/grammatikfehler-statistik (Zugriff: 5. November 2026).
korrektur.de. „Grammatikfehler in Abschlussarbeiten: Statistik.“ Zuletzt geändert 5. November 2026. https://korrektur.de/grammatikfehler-statistik.
korrektur.de. Grammatikfehler in Abschlussarbeiten: Statistik [online]. 2026 [Zugriff am 05.11.2026]. Verfügbar unter: https://korrektur.de/grammatikfehler-statistik
Quellen und Stand
- Eigene Auswertung korrektur.de (geprüft am 2026-11-05)