Werden Abschlussarbeiten schlechter: Meldungen im Zeitverlauf
 Fachlich geprüft von Benjamin Lohrer, Lektor bei korrektur.de · Stand: 9. November 2026
Kommameldungen je 1.000 Wörter nach Jahrzehnt, gefiltert vor der Bereinigung
Die Jahrzehnte im Überblick, Quellen anonym
| Jahrzehnt | Arbeiten | Jahre | Hochschulquellen | größte Quelle (Prozent) |
|---|---|---|---|---|
| 2000er | 82 | 2003 bis 2009 | 5 | 41,5 |
| 2010er | 660 | 2010 bis 2019 | 7 | 48,5 |
| 2020er | 208 | 2020 bis 2026 | 6 | 45,7 |
Gefilterte Meldungen je 1.000 Wörter vor der Bereinigung (nur Arten mit Zahl)
| Jahrzehnt | Arbeiten | Kommasetzung | übrige Zeichensetzung | Getrennt- und Zusammenschreibung | Wortverwechslung |
|---|---|---|---|---|---|
| 2000er | 82 | 0,87 | 0,073 | 0,46 | 0,056 |
| 2010er | 660 | 0,70 | 0,062 | 0,36 | 0,060 |
| 2020er | 208 | 0,47 | 0,031 | 0,17 | 0,044 |
| alle Arbeiten | 950 | 0,67 | 0,056 | 0,33 | 0,056 |
Trefferquote über alle Arbeiten, nicht je Gruppe gemessen
| Fehlerart | Status | Trefferquote (Bereich) |
|---|---|---|
| Rechtschreibung | nur Rang | 43,3 % (34,8 bis 52,3) |
| Grammatik | nur Rang | 67,5 % (58,7 bis 75,2) |
| Kommasetzung | Zahl | 70,8 % (62,2 bis 78,2) |
| übrige Zeichensetzung | Zahl | 75,0 % (66,6 bis 81,9) |
| Groß- und Kleinschreibung | nur Rang | 65,8 % (57,0 bis 73,7) |
| Getrennt- und Zusammenschreibung | Zahl | 72,5 % (63,9 bis 79,7) |
| Wortverwechslung | Zahl | 71,7 % (63,0 bis 79,0) |
Werden Abschlussarbeiten schlechter: Verlauf nach Jahrzehnt
In der eigenen Auswertung von korrektur.de über das Korpus von 950 offenen Abschlussarbeiten (Stand 5. November 2026) sinken die gefilterten Meldungen je 1.000 Wörter vor der Bereinigung von den 2000ern zu den 2020ern bei Kommasetzung von 0,87 auf 0,47, ohne dass dies bessere oder schlechtere Arbeiten belegt. Auch bei übriger Zeichensetzung (0,073 auf 0,031) und Getrennt- und Zusammenschreibung (0,46 auf 0,17) sinken die Werte. Bei der Wortverwechslung liegen die 2020er mit 0,044 unter den 0,056 der 2000er, dazwischen steigt der Wert in den 2010ern leicht auf 0,060. Weil jedoch der Quellenmix zwischen den Jahrzehnten wechselt und die Trefferquote nicht je Gruppe gemessen wurde, erlauben die Daten kein Urteil über die Qualität von Studierenden oder Hochschulen.
Kurzantwort: Was die Kernzahl im Zeitverlauf zeigt
Nach der eigenen Auswertung von korrektur.de auf Basis des Korpus von 950 offenen Abschlussarbeiten mit 4.712.082 Wörtern aus 8 Hochschulquellen (Stand 5. November 2026) gehen die gefilterten Meldungen je 1.000 Wörter vor der Bereinigung von den 2000ern über die 2010er zu den 2020ern bei Kommasetzung von 0,87 über 0,70 auf 0,47 zurück. Ein Rückgang zeigt sich im selben Zeitraum auch bei der Getrennt- und Zusammenschreibung von 0,46 über 0,36 auf 0,17, bei der übrigen Zeichensetzung von 0,073 über 0,062 auf 0,031 sowie im Vergleich von den 2000ern zu den 2020ern bei der Wortverwechslung von 0,056 über 0,060 auf 0,044. Die Zahlen dieser Werden-Abschlussarbeiten-schlechter-Statistik zeigen damit von den 2000ern zu den 2020ern keinen Anstieg der Meldungen, belegen wegen des wechselnden Anteils der Hochschulquellen und der nur über das Gesamtkorpus gemessenen Trefferquote aber ebenso wenig, dass Abschlussarbeiten über die Jahrzehnte besser oder schlechter werden.
Wenn du über den Zeitverlauf hinaus weitere Auswertungen suchst, findest du auf korrektur.de auch den Fehlerreport zu Abschlussarbeiten sowie die Statistik zu Fehlern nach Studienfach. Beide Seiten behandeln eigene Fragestellungen, ohne dass hier ihre Datenbasis oder Zahlen beschrieben werden.
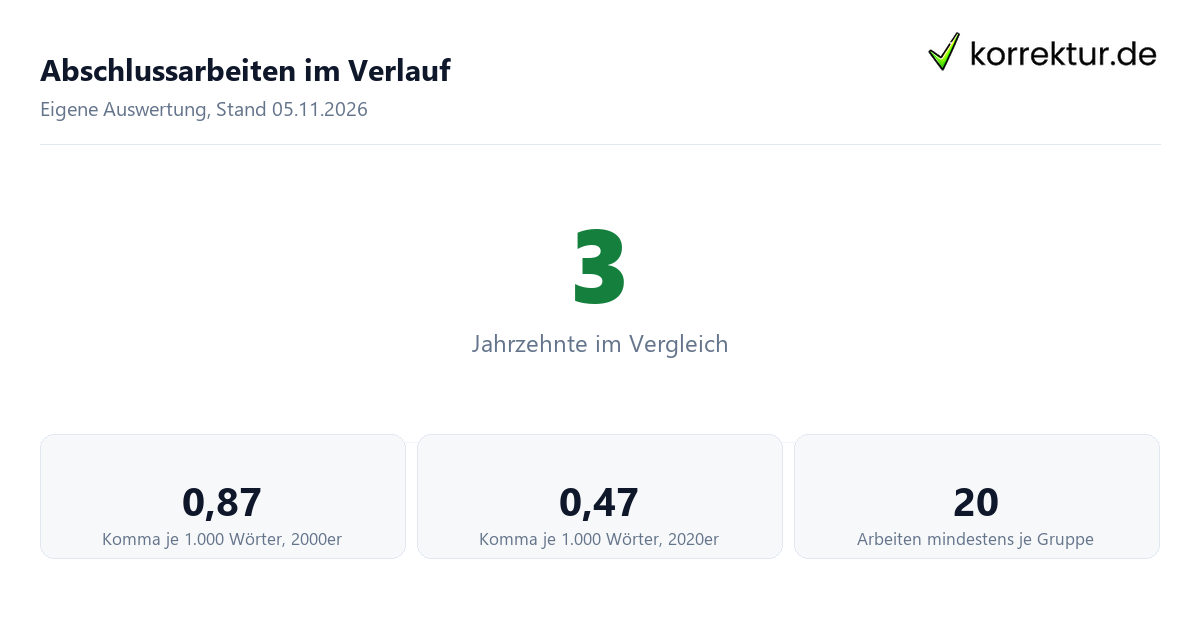
Verglichene Jahrzehnte und Anzahl der Arbeiten im Korpus
Für den Vergleich nach Entstehungszeit werden die 950 offenen Abschlussarbeiten des Korpus aus 8 Hochschulquellen mit insgesamt 4.712.082 Wörtern aus den Entstehungsjahren 2003 bis 2026 (ausdrücklich keine Kundentexte) ihrem jeweiligen Jahrzehnt zugeordnet. Ausgewiesen werden in der Auswertung ausschließlich Jahrzehnte, die mindestens 20 untersuchte Texte erreichen; eine Darstellung einzelner Kalenderjahre unterbleibt, weil die Teilmengen sonst zu gering ausfielen. Auf diese Weise entstehen drei ausgewertete Jahrzehnte ab der Mindestgröße von 20 Arbeiten: die 2000er mit 82 Arbeiten und 395.082 Wörtern, die 2010er mit 660 Arbeiten und 3.293.197 Wörtern sowie die 2020er mit 208 Arbeiten und 1.023.803 Wörtern.
Bei der Betrachtung dieser drei Zeitabschnitte musst du beachten, dass die beiden äußeren Jahrzehnte keine vollen zehn Kalenderjahre abdecken. Das erste Jahrzehnt (2000er) beinhaltet im Korpus lediglich die Entstehungsjahre 2003 bis 2009 und stützt sich auf 5 Hochschulquellen, wobei die größte Quelle einen Anteil von 41,5 Prozent erreicht. Das jüngste Jahrzehnt (2020er) reicht von 2020 bis 2026, beruht auf 6 Hochschulquellen mit einem Höchstanteil einer einzelnen Quelle von 45,7 Prozent und ist zum Stand 5. November 2026 noch nicht abgeschlossen. Lediglich die 2010er bilden mit dem Zeitraum von 2010 bis 2019 und 7 beteiligten Hochschulquellen (größter Quellenanteil bei 48,5 Prozent) eine vollständig abgeschlossene Dekade ab.
| Jahrzehnt | Arbeiten | Wörter | Jahre | Hochschulquellen | größte Quelle |
|---|---|---|---|---|---|
| 2000er | 82 | 395.082 | 2003 bis 2009 | 5 | 41,5 Prozent |
| 2010er | 660 | 3.293.197 | 2010 bis 2019 | 7 | 48,5 Prozent |
| 2020er | 208 | 1.023.803 | 2020 bis 2026 | 6 | 45,7 Prozent |
Verlauf der gefilterten Meldungen von Jahrzehnt zu Jahrzehnt
Die Vergleichswerte zwischen den Jahrzehnten sind gefilterte Meldungen (Treffer von LanguageTool nach Filter) je 1.000 Wörter vor der Bereinigung und werden ausschließlich für die vier Arten mit dem Status Zahl ausgewiesen. Vor der Bereinigung heißen diese Werte immer Meldungen und nie Fehler, weil die Trefferquote über alle Arbeiten zusammen gemessen wurde und nicht getrennt je Gruppe vorliegt. Für die übrigen drei untersuchten Kategorien (Grammatik mit 67,5 Prozent Trefferquote im Bereich von 58,7 bis 75,2, Groß- und Kleinschreibung mit 65,8 Prozent im Bereich von 57,0 bis 73,7 sowie Rechtschreibung mit 43,3 Prozent im Bereich von 34,8 bis 52,3) gilt der Status Rangfolge, da sie den Grenzwert von mindestens 70 Prozent Trefferquote bei mindestens 100 Urteilen unterschreiten; für sie wird keine Gruppenzahl ausgewiesen. Über alle 950 Arbeiten des Gesamtkorpus zusammen betragen die gefilterten Meldungen je 1.000 Wörter bei Kommasetzung 0,67, bei übriger Zeichensetzung 0,056, bei Getrennt- und Zusammenschreibung 0,33 und bei Wortverwechslung 0,056.
- Zeitraum von 2003 bis 2009 (Jahrzehnt der 2000er): Diese Gruppe bündelt 82 untersuchte Abschlussarbeiten mit einem Gesamtumfang von 395.082 Wörtern, verteilt auf 5 Hochschulquellen (Anteil der größten Einzelquelle: 41,5 Prozent). Je 1.000 Wörter erreichen die gefilterten Meldungen hier 0,87 bei der Kommasetzung, 0,46 bei der Getrennt- und Zusammenschreibung, 0,073 bei der übrigen Zeichensetzung sowie 0,056 bei der Wortverwechslung.
- Zeitraum von 2010 bis 2019 (Jahrzehnt der 2010er): In dieser Dekade liegen 660 Abschlussarbeiten mit zusammen 3.293.197 Wörtern aus 7 Hochschulquellen vor (Anteil der größten Einzelquelle: 48,5 Prozent). Je 1.000 Wörter betragen die gefilterten Meldungen in diesem Abschnitt 0,70 für Komma, 0,36 für Getrennt- und Zusammenschreibung, 0,062 für übrige Zeichensetzung und 0,060 für Wortverwechslung.
- Zeitraum von 2020 bis 2026 (Jahrzehnt der 2020er): Auf diese Gruppe entfallen 208 Abschlussarbeiten mit insgesamt 1.023.803 Wörtern aus 6 Hochschulquellen (Anteil der größten Einzelquelle: 45,7 Prozent). Je 1.000 Wörter belaufen sich die gefilterten Meldungen auf 0,47 im Bereich Komma, 0,17 bei der Getrennt- und Zusammenschreibung, 0,031 bei der übrigen Zeichensetzung sowie 0,044 bei der Wortverwechslung.
In der Richtung laufen die Werte bei Kommasetzung, übriger Zeichensetzung sowie Getrennt- und Zusammenschreibung von Jahrzehnt zu Jahrzehnt nach unten. Bei der Wortverwechslung liegt der Wert in den 2010ern mit 0,060 geringfügig über den 0,056 der 2000er und sinkt in den 2020ern auf 0,044. Eine Ursache für diese Entwicklung benennt die Auswertung nicht; aus den Zahlen folgt ausdrücklich weder, dass Abschlussarbeiten besser, noch dass sie schlechter werden. Wer neben dem Jahrzehntevergleich weitere Themengebiete auf korrektur.de erkunden will, kann sich Fehlervergleich von Bachelor und Master sowie die Statistik zu Zeichensetzungsfehlern ansehen.
Wechselnder Quellenmix: Warum der Verlauf kein Beleg ist
Der beobachtete Verlauf der Meldungsdichte ist kein Beleg für eine veränderte sprachliche Qualität über die Zeit, weil der Quellenmix von Jahrzehnt zu Jahrzehnt wechselt. Insgesamt stammen die Arbeiten aus 8 Hochschulquellen, die hier bewusst anonym bleiben und weder als einzelne Hochschule noch als Repositorium beim Namen genannt werden. In den 2000ern setzen sich die 82 Arbeiten aus 5 Quellen zusammen, wobei die größte Quelle 41,5 Prozent stellt. In den 2010ern verteilen sich die 660 Arbeiten auf 7 Quellen mit einem Anteil der größten Quelle von 48,5 Prozent, und in den 2020ern stammen die 208 Arbeiten aus 6 Quellen, von denen die größte 45,7 Prozent ausmacht.
Durch diese wechselnde Verteilung können die gemessenen Unterschiede zwischen den drei Gruppen allein an der Zusammensetzung der Quellen liegen und nicht an den Entstehungsjahren selbst. Zudem sind die Abstände zwischen den Gruppen klein. Deshalb wird in dieser Auswertung keine Ursache für den Rückgang der Meldungen behauptet: Weder Rechtschreibprogramme noch die Betreuung an den Hochschulen noch geänderte formale Vorgaben der Hochschulen werden als Grund für die niedrigeren Werte in den jüngeren Jahrzehnten angeführt.
Rechtschreibung und alte Schreibung ab 2007 im Zeitverlauf
Für die Rechtschreibung gibt es in dieser Auswertung weder für das Gesamtkorpus noch für einzelne Jahrzehnte eine Meldungs- oder Fehlerzahl, weil diese Kategorie den Status Rangfolge trägt. Gleiches gilt für Grammatik und für Groß- und Kleinschreibung, die ebenfalls den Status Rangfolge haben und in keiner Gruppe eine Zahl erhalten. Warum es hier keine Zahl gibt, folgt einer festen Regel: Liegt die Trefferquote unter dem Grenzwert von 70 Prozent oder die Zahl der Urteile unter 100, ist nur die Reihenfolge belastbar, während eine konkrete Fehlerzahl geraten wäre. Bei der Rechtschreibung beträgt die Trefferquote in der Stichprobe 43,3 Prozent (Bereich 34,8 bis 52,3), sodass in der Stichprobe mehr als die Hälfte kein Fehler war; bei der Grammatik liegt die Trefferquote bei 67,5 Prozent (Bereich 58,7 bis 75,2) und bei der Groß- und Kleinschreibung bei 65,8 Prozent (Bereich 57,0 bis 73,7).
Bei der Rechtschreibung kommt für den Zeitverlauf eine weitere methodische Grenze hinzu: Meldungen zur alten Schreibung, als frei erfundenes Muster etwa daß statt dass, werden im Korpus erst ab dem Jahr 2007 gewertet. Die Übergangsfristen der Rechtschreibreform waren bis dahin ausgelaufen, weshalb ältere Arbeiten aus den Jahren 2003 bis 2006 bei diesen Meldungen außen vor bleiben. Aus beiden Gründen gibt es auf dieser Seite keine Aussage darüber, ob früher mehr oder weniger Rechtschreibfehler in Abschlussarbeiten vorgekommen seien. Ergänzend existiert auf korrektur.de eine separate Statistik zu Rechtschreibfehlern als eigene Übersichtsseite.
Einordnung: Was du aus den Zahlen ableiten darfst und was nicht
Für die sachliche Verwendung der Daten musst du genau trennen, welche Schlüsse durch das Korpus gedeckt sind und welche nicht. Zwei Dinge lassen sich aus den vorliegenden Werten direkt ableiten:
- Kein Anstieg der gefilterten Meldungen im Korpus: Für die vier ausgewiesenen Arten Kommasetzung, übrige Zeichensetzung, Getrennt- und Zusammenschreibung sowie Wortverwechslung liegen die gefilterten Meldungen je 1.000 Wörter vor der Bereinigung in den 2020ern niedriger als in den 2000ern. Begründet ist dies direkt durch die gemessenen Gruppenwerte der 950 untersuchten Arbeiten, etwa beim Rückgang der Kommameldungen von 0,87 auf 0,47 je 1.000 Wörter.
- Überlegenheit von Komma gegenüber Wortverwechslungsmeldungen in jedem Jahrzehnt: Innerhalb jedes der drei betrachteten Jahrzehnte treten gefilterte Meldungen zur Kommasetzung häufiger je 1.000 Wörter auf als gefilterte Meldungen zu Wortverwechslungen. Das ergibt sich unmittelbar aus den Abständen in den 2000ern (0,87 zu 0,056), den 2010ern (0,70 zu 0,060) und den 2020ern (0,47 zu 0,044).
Demgegenüber stehen zwei Dinge, die du aus dieser Auswertung ausdrücklich nicht ableiten darfst:
- Keine Aussage über alle Studierenden oder alle Hochschulen: Das Korpus umfasst ausschließlich 950 offene Abschlussarbeiten aus 8 Hochschulquellen, überwiegend aus Fachhochschulen und Hochschulen für angewandte Wissenschaften. Es ist keine repräsentative Stichprobe aller Abschlussarbeiten, erlaubt keine Hochrechnung und trägt kein Qualitätsurteil über Studierende, Fächer oder Hochschulen.
- Keine Aussage über nicht gemeldete Stellen oder eine Gesamtqualität: Die Zahlen beziehen sich ausschließlich auf die durch LanguageTool nach Filter gemeldeten und in der Stichprobe beurteilten Stellen. Weil der Filter auf Genauigkeit statt auf Vollständigkeit ausgelegt ist, bleibt alles unberücksichtigt, was das Verfahren nicht meldet, und es lässt sich kein Schluss ziehen, dass Arbeiten insgesamt besser oder schlechter geschrieben seien.
Diese Auswertung beschreibt ausschließlich die gemessenen Befunde des Korpus und gibt keinen Rat dazu, wie du dich beim Verfassen einer Arbeit verhalten sollst.
Methodik, Prüfverfahren und Grenzen der Auswertung
Grundlage der Untersuchung mit Stand vom 5. November 2026 (Methodikstand November 2026) ist das Gesamtkorpus aus 950 offenen Abschlussarbeiten mit zusammen 4.712.082 Wörtern aus den Entstehungsjahren 2003 bis 2026, verteilt auf 8 Hochschulquellen. Es sind keine Kundentexte enthalten, und es werden weder Textstellen noch Titel, Verfasser oder Hochschulen als Beispiel angeführt. Im technischen Verfahren prüft die Rechtschreib- und Grammatikprüfung LanguageTool die Texte und gibt Meldungen aus, woraufhin ein Filter bekannte Fehlalarme entfernt. Anschließend wurde je Fehlerart eine Zufallsstichprobe gezogen und im Einzelurteil Stelle für Stelle als echter Fehler oder kein Fehler eingestuft. Diese Urteile stammen offen ausgewiesen von einem KI-Modell, das unter festen Regeln arbeitete, und wurden stichprobenartig gegengeprüft; menschliche Lektorinnen oder Lektoren kamen dafür nicht zum Einsatz. Allgemeine Informationen zu redaktionellen Dienstleistungen bietet der Bereich Lektorat und Korrekturlesen.
Aus den Einzelurteilen ergibt sich die Trefferquote als Anteil der bestätigten echten Fehler an den geprüften Meldungen inklusive eines Wilson-Bereichs für 95 Prozent Sicherheit. Eine Zahl wird nur vergeben, wenn die Trefferquote mindestens 70 Prozent erreicht und mindestens 100 Urteile vorliegen; andernfalls erhält die Art den Status Rangfolge ohne Fehler- oder Meldungszahl. Da der eingesetzte Filter auf hohe Genauigkeit statt auf Vollständigkeit zielt und nicht gemeldete Verstöße fehlen, stellen bereinigte Zahlen (Meldungen mal Trefferquote) im Status Zahl stets Untergrenzen dar.
Für den Gruppenvergleich nach Entstehungsjahrzehnt gilt eine Mindestgröße von 20 Arbeiten je Gruppe, weshalb keine Einzeljahre ausgewiesen werden. Alle Vergleichswerte der Jahrzehnte sind gefilterte Meldungen je 1.000 Wörter vor der Bereinigung, weil die Trefferquote über das gesamte Korpus und nicht je Gruppe gemessen wurde. Zudem fließen Meldungen zur alten Schreibung erst ab 2007 ein, weil die Übergangsfristen der Reform bis dahin ausgelaufen waren und ältere Arbeiten außen vor bleiben, sodass zur Rechtschreibung im Zeitverlauf keine Aussage getroffen wird. Wesentliche Grenzen der Untersuchung liegen in den kleinen Unterschieden zwischen den Gruppen, dem wechselnden Quellenmix je Jahrzehnt, den unvollständigen Randjahrzehnten (2003 bis 2009 sowie 2020 bis 2026), dem Fehlen einer repräsentativen Stichprobe und dem Verzicht auf jede Ursachenbehauptung.
Zitierhinweis: So zitierst du diese Auswertung korrekt
Du darfst die Zahlen dieser Seite frei verwenden und auf anderen Seiten übernehmen, sofern du korrektur.de als Quelle sowie den Stand der Auswertung immer vollständig mitnennst. Nutze für Quellenangaben in Artikeln, Berichten oder wissenschaftlichen Arbeiten den folgenden fertigen Zitiertext:
korrektur.de (2026): Werden Abschlussarbeiten schlechter? Jahrzehnte: Statistik. Eigene Auswertung von 950 offenen Abschlussarbeiten, Stand 5. November 2026. https://korrektur.de/werden-abschlussarbeiten-schlechter-statistik
Achte beim Übernehmen der Daten darauf, die gefilterten Meldungen je 1.000 Wörter vor der Bereinigung genau so zu benennen und sowohl die Quelle korrektur.de als auch den Stand vom 5. November 2026 direkt bei den Zahlen anzugeben.
So zitierst du diese Seite
Stand: 9. November 2026korrektur.de. (2026, 9. November). Werden Abschlussarbeiten schlechter? Jahrzehnte: Statistik. korrektur.de. https://korrektur.de/werden-abschlussarbeiten-schlechter-statistik
„Werden Abschlussarbeiten schlechter? Jahrzehnte: Statistik.“ korrektur.de, 9. Nov. 2026, korrektur.de/werden-abschlussarbeiten-schlechter-statistik. Zugriff 9. Nov. 2026.
korrektur.de (2026) Werden Abschlussarbeiten schlechter? Jahrzehnte: Statistik. Verfügbar unter: https://korrektur.de/werden-abschlussarbeiten-schlechter-statistik (Zugriff: 9. November 2026).
korrektur.de. „Werden Abschlussarbeiten schlechter? Jahrzehnte: Statistik.“ Zuletzt geändert 9. November 2026. https://korrektur.de/werden-abschlussarbeiten-schlechter-statistik.
korrektur.de. Werden Abschlussarbeiten schlechter? Jahrzehnte: Statistik [online]. 2026 [Zugriff am 09.11.2026]. Verfügbar unter: https://korrektur.de/werden-abschlussarbeiten-schlechter-statistik
Quellen und Stand
- Eigene Auswertung korrektur.de (geprüft am 2026-11-05)