Die Normalverteilung verstehen
 Fachlich geprüft von Benjamin Lohrer, Lektor bei korrektur.de · Stand: 27. Oktober 2026
Die Glockenkurve der Normalverteilung und ihre Faustregel
Die Normalverteilung bildet eines der wichtigsten theoretischen Modelle der Statistik und gilt zugleich als zentrale Voraussetzung zahlreicher klassischer Analyseverfahren. Wer dieses Verteilungskonzept für die eigene Datenauswertung fundiert verstehen möchte, findet in diesem Beitrag eine klare Definition der symmetrischen Glockenkurve, eine Einordnung von Mittelwert und Standardabweichung sowie die praktische Anwendung der 68-95-99-Regel. Darüber hinaus erfährst du Schritt für Schritt, wie sich die Verteilungsannahme an deinen erhobenen Daten sowohl über grafische Darstellungen als auch mithilfe formaler statistischer Tests zuverlässig überprüfen lässt.
Definition, Verlauf und zentrale Merkmale der Normalverteilung
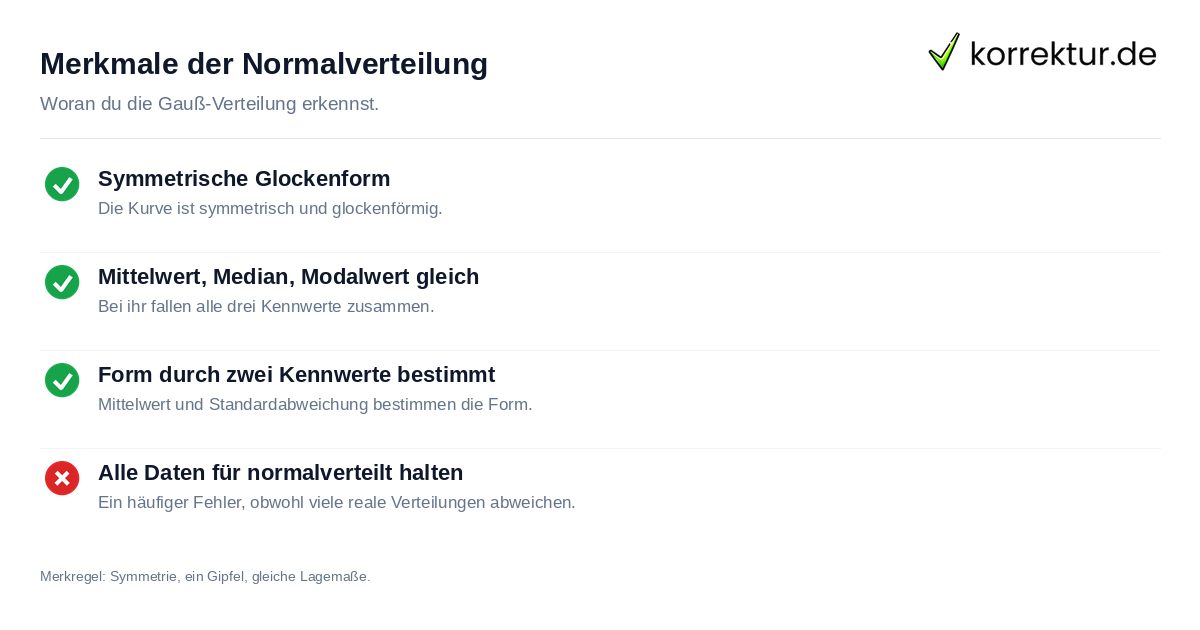
In der Statistik beschreibt die Normalverteilung, die in der Fachliteratur ebenso als Gauß-Verteilung bezeichnet wird, eine stetige, vollkommen symmetrische und glockenförmig verlaufende Wahrscheinlichkeitsverteilung. Wie steil oder flach diese charakteristische Glockenkurve ausfällt und wo ihr Zentrum auf der Skala liegt, hängt vollständig von zwei mathematischen Kennwerten ab: Während der Mittelwert μ als Lageparameter den genauen Schwerpunkt der Verteilung festlegt, steuert die Standardabweichung σ als Streuungsparameter die Breite der Kurve. Ein wesentliches Erkennungsmerkmal dieser idealen Symmetrie besteht darin, dass Mittelwert, Median und Modalwert exakt am selben Punkt im Gipfel der Verteilung übereinstimmen und die Häufigkeitsdichte zu beiden Seiten hin gleichmäßig abnimmt.
Die 68-95-99-Regel als praktische Faustregel zur Streuung
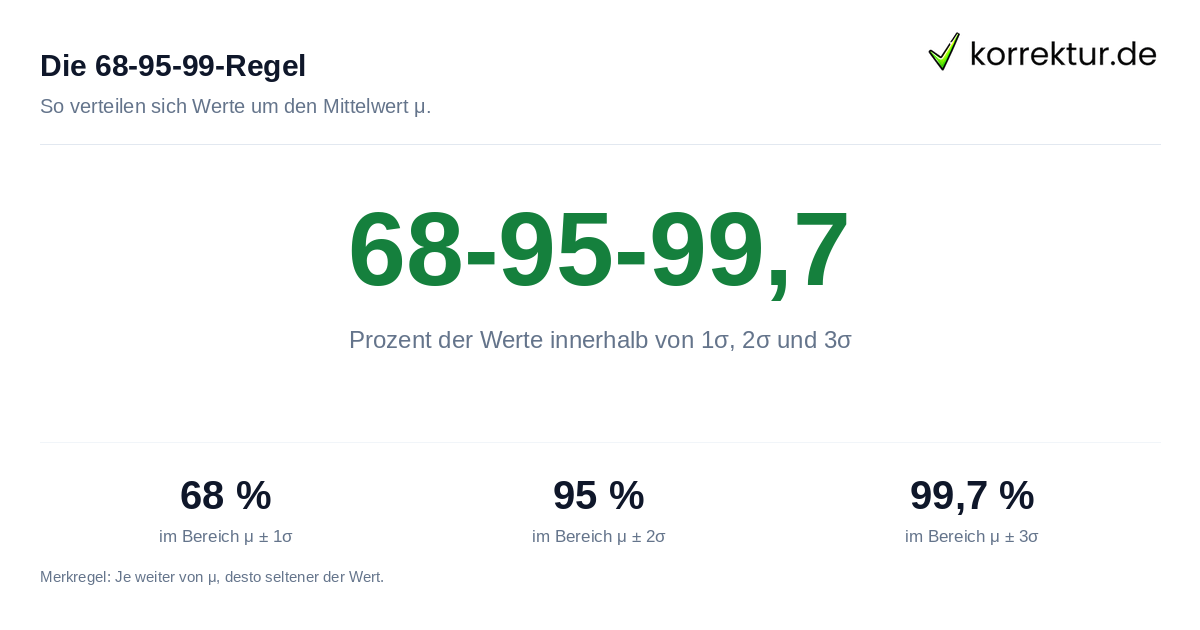
Liegt eine normalverteilte Zufallsvariable vor, folgt die Verteilung der Messwerte rund um das Zentrum einer festen mathematischen Gesetzmäßigkeit. Misst man die symmetrischen Abstände ausgehend vom Mittelwert μ in Vielfachen der jeweiligen Standardabweichung σ, ergeben sich für die eingeschlossenen Intervalle unmittelbar folgende Wahrscheinlichkeiten beziehungsweise Datenanteile:
- rund 68 % sämtlicher Beobachtungswerte fallen in das zentrale Intervall im Bereich μ ± 1σ rund um das arithmetische Mittel
- rund 95 % der gesamten Messwerte befinden sich innerhalb der erweiterten Grenzen im Bereich μ ± 2σ beiderseits des Zentrums
- rund 99,7 % aller Ausprägungen der Verteilung liegen im Bereich μ ± 3σ, sodass Werte außerhalb dieser Spanne nur äußerst selten auftreten
Mithilfe dieser empirischen Orientierungshilfe kannst du in der praktischen Datenauswertung ohne aufwendige Integralrechnung rasch beurteilen, in welchem typischen Schwankungsbereich der Großteil deiner Messwerte liegt. Zugleich wird sofort erkennbar, ab welcher Entfernung vom Durchschnitt einzelne Beobachtungen als ungewöhnlich extreme Ausprägung oder potenzieller Ausreißer einzustufen sind.
Der z-Wert und die Standardnormalverteilung bei der Standardisierung
Um Messergebnisse unabhängig von ihrer ursprünglichen Maßeinheit einzuordnen, lässt sich jede einzelne Beobachtung über die Transformationsformel z = (x minus μ) / σ in einen einheitslosen z-Wert umrechnen. Folgt bereits die zugrunde liegende Ausgangsgröße einer Normalverteilung, gehen die auf diese Weise zentrierten und skalierten Messwerte direkt in eine Standardnormalverteilung mit Mittelwert 0 und Standardabweichung 1 über. Durch diese rechnerische Standardisierung wird es möglich, Werte aus völlig unterschiedlichen Skalen oder Datensätzen unmittelbar miteinander zu vergleichen und zugehörige Wahrscheinlichkeiten direkt in einer z-Tabelle abzulesen. Zahlreiche schließende Berechnungen in der Inferenzstatistik, etwa die präzise Bestimmung eines Konfidenzintervalls, greifen unmittelbar auf diese standardisierten Quantile zurück.
Zentrale Bedeutung der Normalverteilung für statistische Tests
In der empirischen Forschung ist es entscheidend zu wissen, auf welche Größe sich die Verteilungsannahme im jeweiligen Analyseverfahren konkret bezieht: Während die Voraussetzung bei t-Tests je nach gewählter Testvariante entweder für die Messwerte innerhalb der einzelnen Vergleichsgruppen oder aber für die paarweisen Differenzen verbundener Messungen gilt, richtet sie sich bei der linearen Regression für die klassische Inferenz ausschließlich auf die nicht erklärten Fehler beziehungsweise Residuen des Modells. Ob die jeweils maßgebliche Größe tatsächlich annähernd normalverteilt ist, prüfst du in der Praxis am besten durch die Kombination aus einer visuellen Kontrolle mittels Histogramm oder Q-Q-Plot und formalen Signifikanzverfahren wie dem Shapiro-Wilk-Test. Zwar sorgt der zentrale Grenzwertsatz unter geeigneten Voraussetzungen dafür, dass sich die Stichprobenverteilung von Mittelwerten bei hinreichend großem Umfang einer Glockenform annähert, doch ob konkrete Abweichungen von der Idealform im Einzelfall vernachlässigbar bleiben, hängt stets vom gewählten Verfahren, der Stichprobengröße und der genauen Struktur deiner Daten ab.
Häufige Fehler bei der Anwendung und Überprüfung
Bei der Auswertung empirischer Erhebungen unterläuft Studierenden und Forschenden häufig der Denkfehler, ungeprüft vorauszusetzen, dass nahezu alle erhobenen Daten von Natur aus normalverteilt seien, obwohl zahlreiche reale Verteilungen in der Praxis deutlich schief verlaufen oder mehrgipflig ausfallen. Ebenso problematisch ist es, die 68-95-99-Regel pauschal auf solche asymmetrischen oder nicht normalverteilten Datensätze zu übertragen, da die bekannten Prozentanteile dort ihre Gültigkeit verlieren. Ein weiterer klassischer Fehlschluss entsteht, wenn das Ergebnis beim Shapiro-Wilk-Test in sehr großen Stichproben isoliert überinterpretiert wird, denn bei hohem Stichprobenumfang werden oft schon fachlich völlig unbedeutende, winzige Abweichungen von der Glockenkurve statistisch signifikant.
Wer die Normalverteilung verstehen und darüber hinaus noch tiefergehende Statistik-Grundlagen für die eigene Auswertung nutzen möchte, findet in unseren weiterführenden Leitfäden zur Standardabweichungsberechnung sowie zum Konfidenzintervall konkrete Rechenschritte. Unser Überblick für die deskriptive Statistik erklärt dir außerdem alle wichtigen Lage- und Streuungsmaße im Zusammenhang, während der zentrale Statistik-und-SPSS-Hub zahlreiche ergänzende Themen rund um Hypothesentests und Datenanalyse bündelt. Damit am Ende nicht nur deine Berechnungen stimmen, sondern auch die Formulierung im Ergebnisteil überzeugt, kann ein professionelles Korrekturlesen deine wissenschaftliche und sprachliche Berichtsweise sorgfältig prüfen.
So zitierst du diese Seite
Stand: 27. Oktober 2026korrektur.de. (2026, 27. Oktober). Normalverteilung: Definition und 68-95-99-Regel. korrektur.de. https://korrektur.de/normalverteilung-erklaert
„Normalverteilung: Definition und 68-95-99-Regel.“ korrektur.de, 27. Okt. 2026, korrektur.de/normalverteilung-erklaert. Zugriff 31. Okt. 2026.
korrektur.de (2026) Normalverteilung: Definition und 68-95-99-Regel. Verfügbar unter: https://korrektur.de/normalverteilung-erklaert (Zugriff: 31. Oktober 2026).
korrektur.de. „Normalverteilung: Definition und 68-95-99-Regel.“ Zuletzt geändert 27. Oktober 2026. https://korrektur.de/normalverteilung-erklaert.
korrektur.de. Normalverteilung: Definition und 68-95-99-Regel [online]. 2026 [Zugriff am 31.10.2026]. Verfügbar unter: https://korrektur.de/normalverteilung-erklaert