So wertest du deine Befragung für die Abschlussarbeit aus
Auswertung einer Befragung: Daten, Fragen, Ergebnisse
Wenn du eine eigene Befragung für deine Haus- oder Abschlussarbeit erhoben hast, stellt sich die Frage nach der richtigen Reihenfolge der Auswertung. Zuerst bereitest du die Rohdaten auf, danach beschreibst du jede geschlossene Frage einzeln, prüfst Zusammenhänge zwischen zwei Fragen, ordnest offene Antworten zu Kategorien und schreibst am Ende einen Ergebnisteil, der von der Deutung getrennt bleibt. Dieser Text führt dich durch alle Schritte und zeigt an erfundenen Beispielen, wie das in der Praxis aussehen kann.
Rohdaten aufbereiten, bevor die Auswertung beginnt
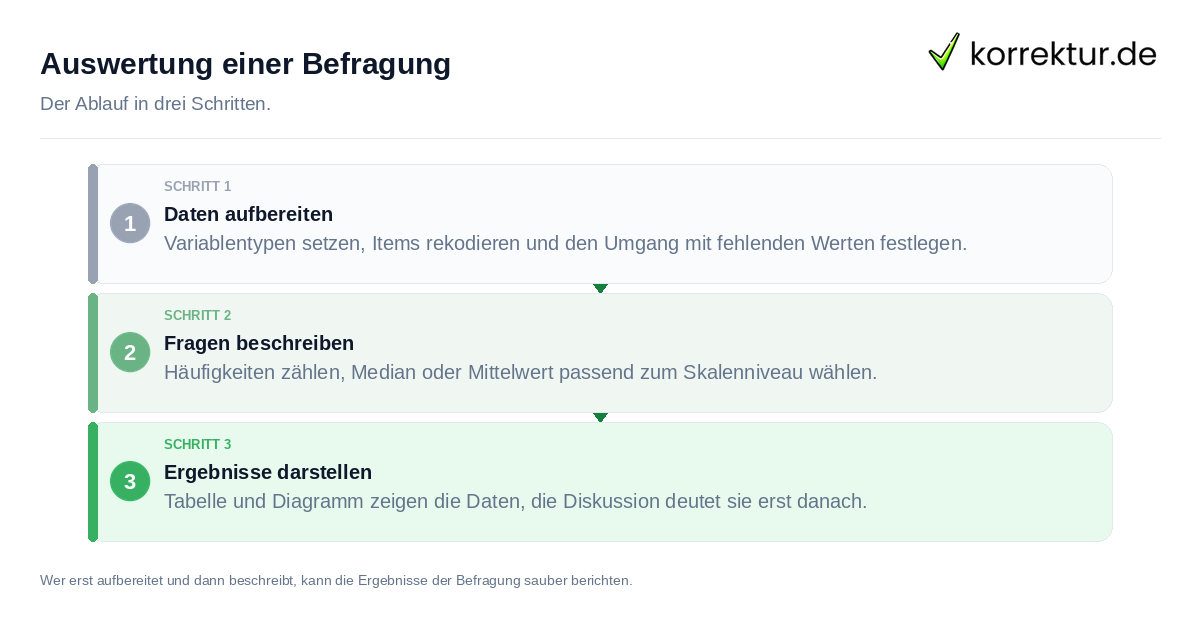
Vor der ersten Auswertung werden die Rohdaten einer Befragung aufbereitet. Dazu gehört zunächst, die Variablentypen so zu setzen, dass sie zum jeweiligen Skalenniveau passen, damit die Auswertungssoftware die Werte richtig verarbeitet. Bei umfangreicheren Fragebögen werden außerdem mehrere Items zu einer gemeinsamen Skala zusammengefasst, etwa indem der Mittelwert mehrerer zusammengehörender Fragen gebildet wird. Negativ formulierte Items werden rekodiert, damit sie in die gleiche Richtung zeigen wie die übrigen Items einer Skala und nicht verzerrend in die Skalenbildung eingehen.
Ein weiterer Baustein ist der Umgang mit fehlenden Werten. Dafür wird vorab eine Strategie festgelegt, etwa ob fehlende Angaben ersetzt oder die betroffenen Fälle ausgeschlossen werden. Auch Ausreißer werden in diesem Schritt erkannt und je nach Ziel der Auswertung behandelt, ohne dass es dafür eine feste Grenze gibt, ab der ein Wert als Ausreißer gilt. Welche Reihenfolge diese Schritte haben, legt die Aufbereitung nicht verbindlich fest, und auch einen erlaubten Anteil fehlender Werte gibt es dafür nicht.
Parallel zur Erstellung des Fragebogens entsteht bei gängigen Umfrageplattformen ein Codebuch, das die Fragen, die jeweiligen Antworttypen und die Kodierungen mit Wertelabels festhält. Dieses Codebuch lässt sich zusammen mit den Rohdaten exportieren und unterstützt so die Dokumentation der Daten, ohne dass daraus eine Pflicht entsteht, ein solches Codebuch in der Arbeit abzugeben. Bevor mit den aufbereiteten Daten weitergerechnet wird, lohnt sich außerdem ein Blick in eine Häufigkeitstabelle je Variable, denn darin lassen sich falsch eingegebene Werte erkennen. Welches Lagemaß zu welchem Skalenniveau passt, zeigt die bestehende Seite zu den Skalenniveaus. Ein eigener Ratgeber zu Deskriptive Statistik vertieft diesen Punkt, und ein eigener Ratgeber zu Korrelationsanalyse: Bedeutung und Anwendung vertieft diesen Punkt ebenfalls.
Geschlossene Fragen deskriptiv beschreiben
Geschlossene Fragen werden zuerst deskriptiv ausgewertet, also je Frage einzeln beschrieben. Dafür werden absolute Häufigkeiten gezählt, also wie oft eine Antwortmöglichkeit gewählt wurde, und relative Häufigkeiten gebildet, die den Anteil dieser Antwort an allen Antworten angeben. Wenn eine Frage sehr viele unterschiedliche Ausprägungen zulässt, werden diese Ausprägungen zu Klassen zusammengefasst, um die Verteilung übersichtlicher darzustellen.
Welches Lagemaß dabei berichtet wird, richtet sich nach dem Skalenniveau der Frage. Bei nominalen Daten wird der Modus als häufigster Wert genannt, ab ordinalem Niveau kommt der Median als mittlerer Wert einer sortierten Reihe hinzu, und bei metrischem Niveau wird zusätzlich das arithmetische Mittel berechnet. Der Median gilt dabei als robust gegenüber Extremwerten, während das Mittel von solchen Werten stärker beeinflusst wird. In der Praxis wird das Mittel bei Likert-Items trotz ihres ordinalen Niveaus häufig berechnet, ohne dass daraus eine Pflicht dazu abgeleitet werden kann.
Neben den Lagemaßen werden auch Streuungsmaße wie Spannweite, Varianz und Standardabweichung berichtet, um zu zeigen, wie weit die Antworten um den mittleren Wert streuen. Wie Antworten auf einer Zustimmungsskala einzuordnen sind, erklärt die bestehende Seite zur Likert-Skala, und die Grundlagen von Häufigkeiten und Lagemaßen stehen ausführlicher in einem eigenen Ratgeber zu diesem Thema. Ein eigener Ratgeber zu Ergebnisteil Bachelorarbeit vertieft diesen Punkt, wenn es darum geht, diese Kennwerte später im Text unterzubringen.
Zusammenhänge zwischen zwei Fragen prüfen
Zusammenhänge zwischen zwei Fragen werden je nach Skalenniveau mit unterschiedlichen Verfahren untersucht. Bei zwei nominalen bis ordinalen Merkmalen steht die Kreuztabelle im Mittelpunkt: Die beiden Variablen werden gegeneinander tabelliert, und die beobachteten Häufigkeiten in den Zellen werden mit den Häufigkeiten verglichen, die zu erwarten wären, wenn die beiden Merkmale nicht zusammenhängen würden.
Bei zwei metrischen Merkmalen wird die Korrelation nach Pearson berechnet, bei zwei ordinalen Merkmalen die Rangkorrelation nach Spearman. Der Korrelationskoeffizient r liegt dabei immer zwischen minus eins und eins und zeigt an, wie stark und in welche Richtung zwei Variablen linear zusammenhängen. Nicht-lineare Zusammenhänge werden durch dieses Maß nicht angemessen erfasst, weshalb die Korrelation nur einen bestimmten Typ von Beziehung abbildet.
Für die Pearson-Korrelation gilt dabei ausdrücklich, dass der Zusammenhang ungerichtet ist: Beide Variablen verändern sich gemeinsam, ohne dass sich sagen ließe, welche die andere bedingt. Auch für die anderen hier genannten Verfahren lässt sich aus einem Zusammenhang keine Ursache ableiten. Grenzwerte dafür, ab wann ein Zusammenhang als schwach, mittel oder stark gilt, nennt das zugrunde liegende Material nicht, ebenso wenig Vorgaben zu Zellgrößen oder zur Prozentuierung einer Kreuztabelle. Mehr zu diesem Verfahren liefert ein eigener Ratgeber zur Korrelation. Welches Skalenniveau welches Verfahren nach sich zieht, zeigt ein eigener Ratgeber zu Skalenniveaus: Überblick, und wer die Berechnung selbst nachvollziehen möchte, findet das in einem eigenen Ratgeber zu Statistische Auswertung mit Excel verstehen.
Offene Antworten zu Kategorien ordnen
Offene Antworten werden ausgewertet, indem man sie zu Kategorien ordnet. Kategorien lassen sich deduktiv bilden, also aus einem Leitfaden, aus Literatur oder aus Vorwissen ableiten, oder induktiv entwickeln, indem sie direkt aus dem gesammelten Material entstehen. Beide Wege führen zu einem System aus Hauptkategorien und Unterkategorien, das zunächst an einem Teil des Materials erprobt wird.
Dieses Kategoriensystem wird anschließend von mindestens zwei Personen unabhängig voneinander angewendet und bei Bedarf überarbeitet, bevor es auf das gesamte Material angewendet wird. Diese Vorgehensweise beschreibt die Quelle aus Freiburg am Beispiel von Interviews, der Bezug auf offene Fragebogenantworten ist deshalb eine Übertragung dieser Methode. Auch die Methodenberatung Zürich erwähnt, dass offene Antworten zu Klassen gruppiert werden, etwa wenn viele unterschiedliche Antworten auf eine Frage vorliegen.
Eine feste Anzahl an Kategorien oder eine Mindestzahl an Antworten, ab der sich dieses Vorgehen lohnt, lässt sich aus den Quellen nicht ableiten. Wer sich näher mit dem gesamten Verfahren beschäftigen möchte, findet das in der Qualitative Inhaltsanalyse: Methoden und Ablauf. Wie ein solches System aus Kategorien in einem Codebuch festgehalten wird, zeigt ein eigener Ratgeber zum Aufbau eines solchen Dokumentationsinstruments. Schon beim Aufbau des Fragebogens lässt sich mitdenken, wie offene Fragen später kategorisiert werden sollen, wie es ein eigener Ratgeber zu Fragebogen erstellen: Aufbau und Ablauf beschreibt. Für die technische Umsetzung mit Statistiksoftware ist außerdem ein eigener Ratgeber zu Auswertung SPSS: Bedeutung und Verwendung hilfreich.
Ergebnisse darstellen und von der Deutung trennen
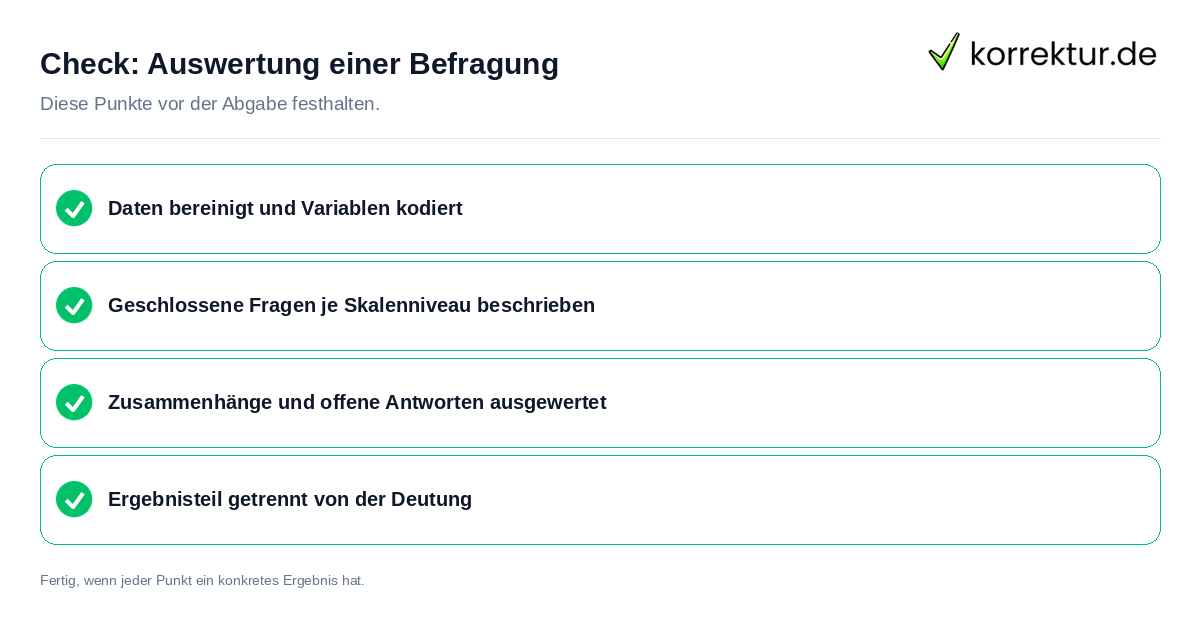
Der Ergebnisteil berichtet, was die Auswertung zeigt, und die Diskussion deutet es. Im Ergebnisteil stehen demnach deskriptive Kennwerte wie Mittelwerte und Standardabweichungen, die Ergebnisse statistischer Tests sowie Tabellen und Grafiken, die diese Zahlen anschaulich machen. Die Einordnung der Ergebnisse in Bezug auf Hypothesen, den theoretischen Rahmen und die Bedeutung für das Fachgebiet gehört dagegen in die Diskussion, ebenso wie Limitationen der Studie.
Dieser Aufbau mit Einleitung, Methodik, Ergebnissen, Diskussion, Zusammenfassung, Literaturverzeichnis und Anhängen ist ein möglicher Aufbau eines wissenschaftlichen Berichts. Welche Gliederung und welche Kapitelnamen tatsächlich verwendet werden, legt das jeweilige Fach zusammen mit der Betreuung fest. Zusätzliche Materialien, die den Haupttext unterbrechen würden, gehören entsprechend in den Anhang statt in den Fließtext des Ergebnisteils.
Für die grafische Darstellung gilt: Ein Balkendiagramm eignet sich für kategoriale und ordinale Daten, ein Kreisdiagramm für Anteile an einer Gesamtheit, ein Histogramm für die Verteilung metrischer Daten, und ein Boxplot zeigt Median, Quartile und Ausreißer in einer Verteilung. Wie ein solcher Ergebnisteil konkret aufgebaut sein kann, zeigt die bestehende Seite zum Ergebnisteil der Bachelorarbeit. Wer offene Antworten im Ergebnisteil berichten möchte, findet die Grundlagen dazu in der Qualitative Inhaltsanalyse: Methoden und Ablauf.
Drei eigenständige Beispiele, typische Fehler und Werkzeuge
Drei kurze Beispiele zeigen, wie die Auswertung einer Befragung aussehen kann.
Drei eigenständige Beispiele
In einem erfundenen Beispiel wird in einer Befragung eine Zustimmungsfrage zur Betreuung im Studium auf einer fünfstufigen Skala gestellt. Für diese Frage wird eine Häufigkeitstabelle je Antwortstufe erstellt, der Median als Lagemaß berechnet und die Verteilung zusätzlich in einem Balkendiagramm dargestellt. So lässt sich die Verteilung der Antworten auf einen Blick erfassen, ohne dass hier konkrete Werte berichtet werden.
In einem zweiten erfundenen Beispiel wird untersucht, ob ein Zusammenhang zwischen dem Studienfach und der Zustimmung zu Onlinelehre besteht. Dafür wird eine Kreuztabelle gebildet, in der die beobachteten Häufigkeiten den erwarteten Häufigkeiten gegenübergestellt werden. Aus einem solchen Zusammenhang lässt sich dabei keine Aussage über eine Ursache ableiten, selbst wenn sich ein Muster in der Tabelle zeigen sollte.
Ein drittes erfundenes Beispiel betrifft eine offene Frage nach dem größten Problem im Studium. Die Antworten werden induktiv zu Kategorien wie Zeitdruck, Organisation und Finanzen zusammengefasst, und dieses Kategoriensystem wird von zwei Personen getrennt auf das Material angewendet, bevor die Ergebnisse verglichen werden.
Bei der Auswertung lassen sich einige Fehler benennen, die aus den Quellen belegt sind: Fehlende Werte werden ohne vorher festgelegte Strategie einfach im Datensatz belassen, der Mittelwert wird für nominale Daten berechnet, obwohl dafür der Modus vorgesehen ist, Ausreißer werden nicht geprüft, ein Zusammenhang aus einer Kreuztabelle oder Korrelation wird fälschlich als Ursache gedeutet, und die Interpretation der Zahlen findet bereits im Ergebnisteil statt, statt in der Diskussion.
Für die technische Umsetzung stehen mehrere Programme zur Verfügung. Excel eignet sich als weit verbreitetes Tabellenkalkulationsprogramm für einfache Datenanalyseaufgaben. SPSS bietet eine benutzerfreundliche Oberfläche für statistische Analysen und ist auch ohne tiefere Programmierkenntnisse nutzbar. R ist eine Open-Source-Programmiersprache für statistische Berechnungen und Grafiken.
| Programm | Eigenschaft |
|---|---|
| Excel | Tabellenkalkulation mit grafischer Oberfläche, für einfache Analysen |
| SPSS | Statistiksoftware mit Oberfläche, ohne tiefe Programmierkenntnisse nutzbar |
| R | Open-Source-Programmiersprache für statistische Berechnungen |
Mehr zur Auswertung mit Excel und mit SPSS findet sich in eigenen Ratgebern zu diesen Programmen. Ein eigener Ratgeber zu Codebuch für eine Inhaltsanalyse entwickeln vertieft diesen Punkt.
Quellen und Stand
- Datenaufbereitung, Forschungsmethoden-Wiki, Methodenzentrum der RPTU Kaiserslautern-Landau: rptu.de (geprüft am 2026-10-05)
- Deskriptivstatistik: Maße & Grafiken, Forschungsmethoden-Wiki der RPTU Kaiserslautern-Landau: rptu.de (geprüft am 2026-10-05)
- Deskriptive, univariate Analyse (Verteilungen), Methodenberatung der Universität Zürich: www.methodenberatung.uzh.ch (geprüft am 2026-10-05)
- Zusammenhänge, Methodenberatung der Universität Zürich: www.methodenberatung.uzh.ch (geprüft am 2026-10-05)
- Korrelationsanalyse, Forschungsmethoden-Wiki der RPTU Kaiserslautern-Landau: rptu.de (geprüft am 2026-10-05)
- Qualitative Inhaltsanalyse, QUASUS der Pädagogischen Hochschule Freiburg: www.ph-freiburg.de (geprüft am 2026-10-05)
- Aufbau eines wissenschaftlichen Berichts, Forschungsmethoden-Wiki der RPTU Kaiserslautern-Landau: rptu.de (geprüft am 2026-10-05)
- Datenanalyse mit dem Statistikprogramm, Forschungsmethoden-Wiki der RPTU Kaiserslautern-Landau: rptu.de (geprüft am 2026-10-05)
- Forschungsdatenmanagement in Befragungsstudien, TU Dresden: tu-dresden.de (geprüft am 2026-10-05)
Das Thema „So wertest du deine Befragung für die Abschlussarbeit aus“ wird hier als Gesamtzusammenhang aufgegriffen.