Die Varianz berechnen
 Fachlich geprüft von Benjamin Lohrer, Lektor bei korrektur.de · Stand: 25. Oktober 2026
Das quadrierte Streuungsmaß: Schritt für Schritt
Wer in der Statistik die Streuung einer Messreihe präzise bestimmen und die Varianz berechnen möchte, bildet das mittlere Abweichungsquadrat aller Beobachtungswerte rund um ihren Durchschnitt und schafft damit zugleich das mathematische Fundament für die Standardabweichung. Dieser Leitfaden erläutert die passende Formel, erklärt den methodischen Unterschied zwischen einer Stichprobe und der vollständigen Grundgesamtheit und führt anhand von einem durchgerechneten Beispiel verständlich durch Rechenweg und Interpretation.
Kostenlos herunterladen
Statistik berichten: Mustersätze für den Ergebnisteil
Die Berechnung der Varianz mit Formel und Beispiel, begleitet von Ergebnisblättern nach APA 7 zu deskriptiver Statistik, t-Test, Korrelation, Regression, Varianzanalyse, Chi-Quadrat-Test und Effektstärke.
Was die Varianz in der Datenanalyse misst
Als zentrales Dispersionsmaß gibt die Varianz (bezeichnet mit dem Symbol s² für Stichprobendaten oder σ² für Populationen) an, wie stark einzelne Beobachtungen streuen, indem sie als mittleres Abweichungsquadrat sämtliche Distanzen vom Mittelwert bündelt. Würde man die einfachen Differenzen zum Durchschnitt direkt summieren, höben sich positive und negative Abweichungen gegenseitig auf. Durch das Quadrieren jeder Differenz fließen hingegen alle Abstände mit positivem Gewicht in das Ergebnis ein, wobei größere Ausreißer überproportional stark berücksichtigt werden. Aus diesem Grund ist der Kennwert stets nichtnegativ und nimmt ausschließlich dann den Wert null an, wenn sämtliche Messwerte der Reihe vollkommen identisch ausfallen. Weil durch die Rechenoperation jedoch eine quadrierte Maßeinheit entsteht, die sich im Forschungsalltag kaum unmittelbar deuten lässt, zieht man für die anschaulichere Standardabweichung im nächsten Schritt die Quadratwurzel.
Die Formel für Stichprobe und Grundgesamtheit
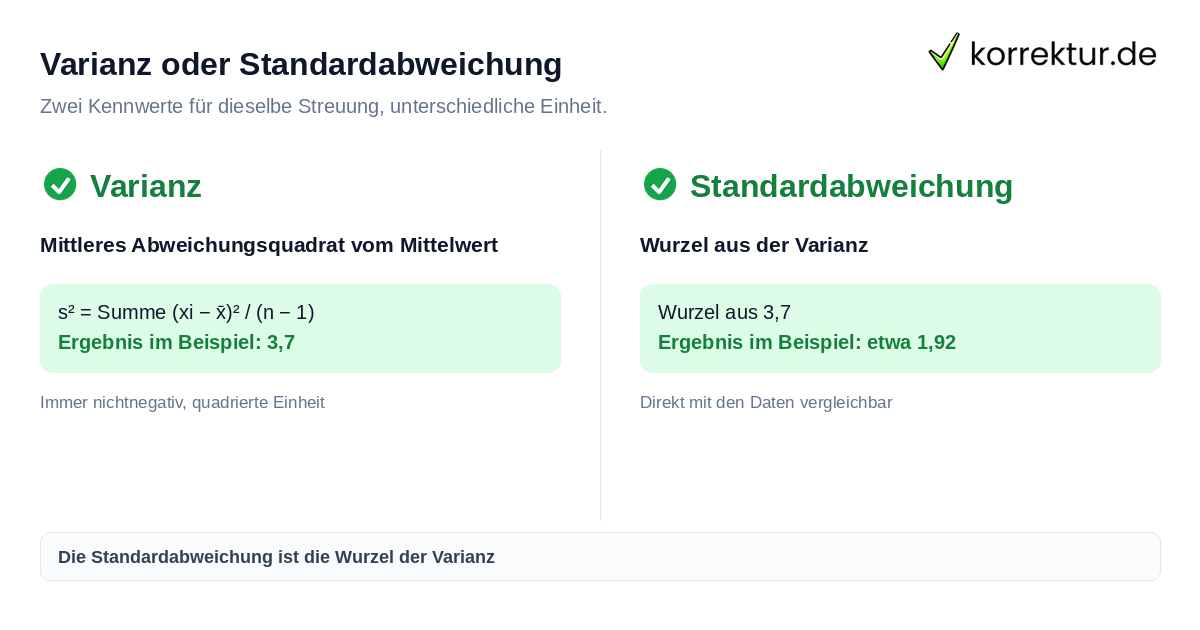
Je nach Datengrundlage unterscheidet die Statistik verschiedene Rechenvorschriften, nämlich für die Stichproben-Varianz die Gleichung s² = Summe (xi minus x̄)² / (n minus 1) sowie für die Populations-Varianz die Gleichung σ² = Summe (xi minus μ)² / n. Im Zähler wird jeweils für jeden einzelnen Beobachtungswert die Differenz zum arithmetischen Durchschnitt x̄ der Teilerhebung beziehungsweise zum wahren Populationsmittel μ gebildet, anschließend quadriert und über alle Beobachtungen summiert. Der wesentliche methodische Unterschied betrifft den Divisor im Nenner der Formel: Sobald die unbekannte Populationsvarianz lediglich anhand einer erhobenen Teilmenge geschätzt werden soll, fungiert n minus 1 als korrigierter Nenner, wohingegen bei einer vollständigen Erhebung aller Elemente der Grundgesamtheit direkt durch den Gesamtumfang n geteilt wird. Da empirische Untersuchungen in der Forschungspraxis fast immer auf Teilauswahlen beruhen, wird für eine unverzerrte und erwartungstreue Schätzung regelmäßig n minus 1 verwendet.
Die Varianz Schritt für Schritt am Beispiel berechnen
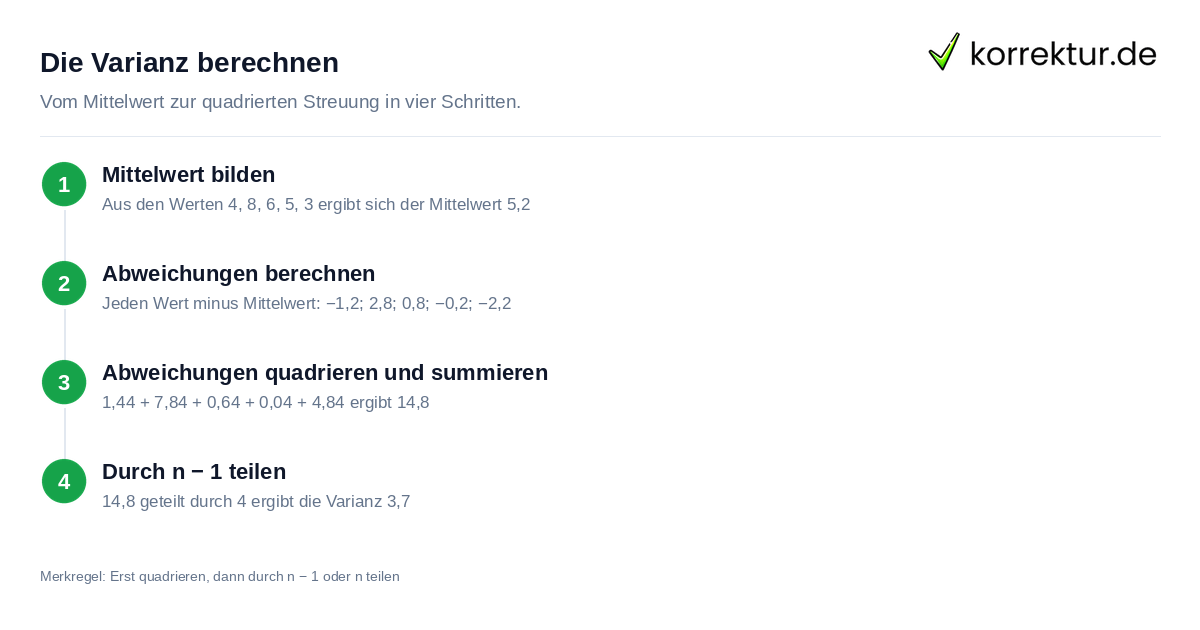
Ein anschauliches Beispiel mit den Messwerten 4, 8, 6, 5, 3 verdeutlicht, wie du in einer empirischen Stichprobe systematisch vorgehst, um die Varianz berechnen und jeden Zwischenschritt sauber prüfen zu können:
- 1. Arithmetischen Mittelwert bestimmen: Addiere zunächst sämtliche Beobachtungswerte der Messreihe und teile die Summe durch die Anzahl der Messungen, woraus sich hier der Durchschnittswert 5,2 ergibt.
- 2. Gerichtete Abweichungen berechnen: Ziehe nun diesen Durchschnittswert einzeln von jedem Messwert der Reihe ab, sodass die jeweiligen Differenzen minus 1,2; 2,8; 0,8; minus 0,2; minus 2,2 entstehen, die sich in der Summe genau aufheben würden.
- 3. Alle ermittelten Abweichungen quadrieren und anschließend zur Quadratsumme addieren: Durch das Quadrieren jedes Abstands entfallen die negativen Vorzeichen, und die Addition ergibt 1,44 + 7,84 + 0,64 + 0,04 + 4,84 = 14,8 als Summe der Abweichungsquadrate.
- 4. Abschließende Division durch den korrigierten Freiheitsgrad n minus 1 = 4: Da es sich um eine Stichprobe handelt, wird die Quadratsumme durch den reduzierten Nenner geteilt, was über die Rechnung 14,8 / 4 = 3,7 unmittelbar zum Endergebnis führt.
Für diesen Datensatz liegt die berechnete Varianz somit bei 3,7 in quadrierter Maßeinheit. Zieht man daraus im letzten Auswertungsschritt die Quadratwurzel, ergibt sich für die leichter interpretierbare Standardabweichung ein Wert von gerundet etwa 1,92 in der ursprünglichen Einheit der gemessenen Daten.
Varianz und Standardabweichung im direkten Vergleich
Sowohl die Varianz als auch die Standardabweichung beschreiben exakt dieselbe Streuungsinformation innerhalb einer Verteilung, drücken diese jedoch auf unterschiedlichen Skalenebenen aus: Während die Varianz aufgrund der Quadrierung mit schwer greifbaren Quadrateinheiten wie Quadratjahren, Quadrateuro oder Quadratsekunden arbeitet, überführt die Standardabweichung als Quadratwurzel der Varianz den Kennwert wieder in die originale Dimension der Messdaten. Dadurch lässt sich die Standardabweichung unmittelbar mit dem arithmetischen Mittel und den Rohwerten vergleichen. In wissenschaftlichen Ergebnisberichten und deskriptiven Tabellen wird deshalb fast immer die Standardabweichung gemeinsam mit dem Durchschnitt ausgewiesen. Die Varianz selbst besitzt hingegen einen hohen mathematischen Stellenwert in der schließenden Statistik, weil sich quadrierte Streuungsanteile additiv zerlegen lassen, was insbesondere bei weiterführenden Analyseverfahren wie der Varianzanalyse oder der Regressionsrechnung unverzichtbar ist.
Häufige Fehler bei Rechenweg, Software und Interpretation
In der praktischen Auswertung entstehen Rechenfehler vor allem durch einen falsch gewählten Nenner im Bruch, das versehentliche Auslassen der Quadrierung einzelner Differenzen oder die begriffliche Verwechslung mit der Standardabweichung beim Berichten der Kennwerte. Ebenso wichtig ist die passende Software-Einstellung in Tabellenkalkulationen und Statistikprogrammen: So stellt Excel mit VAR.S die Funktion für eine Stichprobe und mit VAR.P die Variante für eine vollständige Grundgesamtheit bereit. Für eine sachgerechte Interpretation im Ergebnisteil gilt grundsätzlich: Die Varianz fällt umso höher aus, je weiter die gemessenen Einzelwerte auseinanderliegen und je stärker Ausreißer die Verteilung verbreitern, während ein niedriger Kennwert auf eine homogene Datenlage nahe am Durchschnitt hinweist.
Vertiefende Erläuterungen zu eng verwandten Statistik-Grundlagen findest du in den weiterführenden Beiträgen zur Berechnung der Standardabweichung sowie zu robusten Alternativen wie Quartile und Boxplot bei schiefen Verteilungen. Einen systematischen Überblick über Lageparameter und Streuungsmaße liefert die Einführung in die deskriptive Statistik, während unser Statistik-und-SPSS-Hub alle wichtigen Auswertungsverfahren für Studium und Forschung bündelt. Wenn du deine statistischen Ergebnisse in einer Abschlussarbeit sprachlich präzise und formal fehlerfrei darstellen möchtest, unterstützt dich zudem ein professionelles Korrekturlesen bei der Überprüfung deines Manuskripts.
So zitierst du diese Seite
Stand: 25. Oktober 2026korrektur.de. (2026, 25. Oktober). Varianz berechnen: Formel, Beispiel und Interpretation. korrektur.de. https://korrektur.de/varianz-berechnen
„Varianz berechnen: Formel, Beispiel und Interpretation.“ korrektur.de, 25. Okt. 2026, korrektur.de/varianz-berechnen. Zugriff 31. Okt. 2026.
korrektur.de (2026) Varianz berechnen: Formel, Beispiel und Interpretation. Verfügbar unter: https://korrektur.de/varianz-berechnen (Zugriff: 31. Oktober 2026).
korrektur.de. „Varianz berechnen: Formel, Beispiel und Interpretation.“ Zuletzt geändert 25. Oktober 2026. https://korrektur.de/varianz-berechnen.
korrektur.de. Varianz berechnen: Formel, Beispiel und Interpretation [online]. 2026 [Zugriff am 31.10.2026]. Verfügbar unter: https://korrektur.de/varianz-berechnen