Chi-Quadrat-Test: Formel, Rechenbeispiel, Interpretation
 Fachlich geprüft von Benjamin Lohrer, Lektor bei korrektur.de · Stand: 13. November 2026
Der Test für kategoriale Zusammenhänge
Der Chi-Quadrat-Test prüft, ob zwei kategoriale Merkmale voneinander unabhängig sind. Dazu stellst du in einer Kreuztabelle die gezählten (beobachteten) Häufigkeiten den Häufigkeiten gegenüber, die bei Unabhängigkeit zu erwarten wären: erwartet = (Zeilensumme · Spaltensumme) / Gesamtzahl. Die Prüfgröße lautet χ² = Summe über alle Zellen von (beobachtet minus erwartet)² / erwartet, die Freiheitsgrade df = (Zeilen minus 1) · (Spalten minus 1). Ist der zugehörige p-Wert kleiner als das Signifikanzniveau (meist 0,05), sprechen die Daten gegen Unabhängigkeit. Wie stark der Zusammenhang ist, zeigt erst Cramérs V.
Kostenlos herunterladen
Statistik berichten: Mustersätze für den Ergebnisteil
Der Chi-Quadrat-Test zur Prüfung von Zusammenhängen, dazu zum Herunterladen und Ausdrucken Ergebnisblätter nach APA 7 für deskriptive Statistik, Korrelation, Regression, t-Test, Varianzanalyse, Chi-Quadrat-Test und Effektstärke.
Fragestellung und Einsatzgebiet: Wann sich der Chi-Quadrat-Test eignet
Der Chi-Quadrat-Test (χ²-Test) passt, wenn zwei Variablen mit nominalen oder ordinalen Merkmalen vorliegen und geklärt werden soll, ob zwischen ihnen ein überzufälliger Zusammenhang besteht, etwa zwischen Geschlecht und gewählter Studienrichtung, zwischen Wohnort (Stadt/Land) und Verkehrsmittel oder zwischen Behandlungsgruppe und Therapieerfolg (ja/nein). Weil kategoriale Merkmale Beobachtungen nur in Gruppen einteilen, lassen sich hier keine Mittelwerte vergleichen; gezählt wird, wie oft jede Merkmalskombination auftritt. Genau diese Zellbesetzungen werden mit der Verteilung verglichen, die bei völliger Unabhängigkeit zu erwarten wäre. Für metrische Variablen nimmst du stattdessen Korrelation oder t-Test, für abhängige Messungen bei zwei Zeitpunkten den McNemar-Test.
Berechnung in der Kreuztabelle: Beobachtete und erwartete Häufigkeiten abgleichen
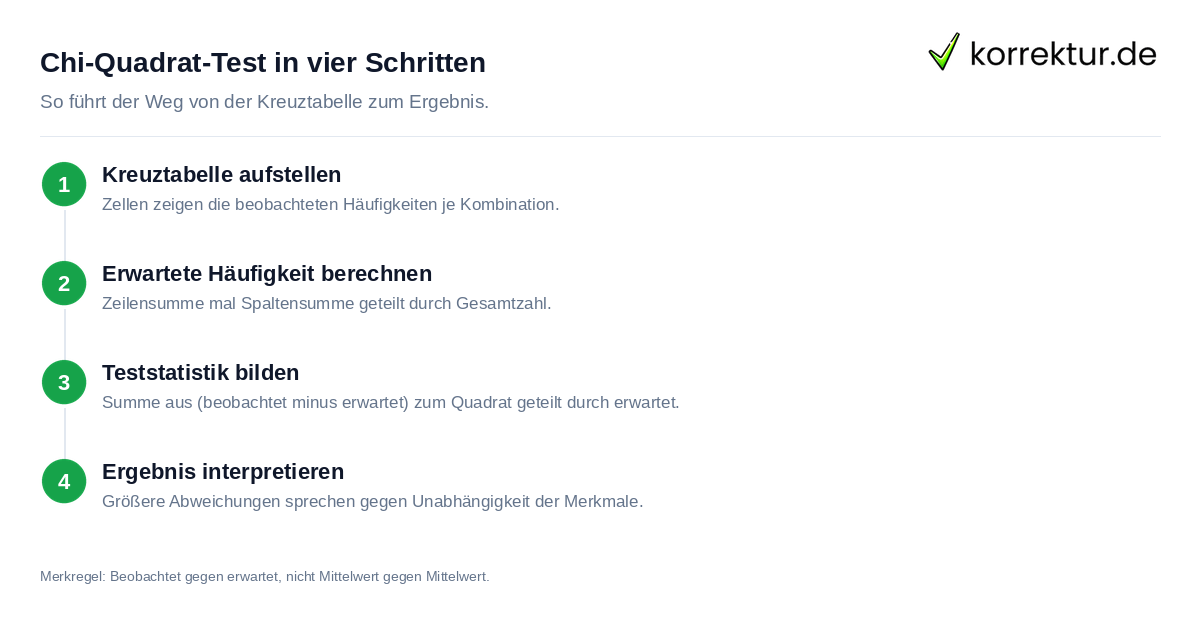
Ausgangspunkt der gesamten Auswertung ist eine übersichtlich aufgebaute Kreuztabelle, in der die Ausprägungen der einen Variable die Zeilen und die der anderen Variable die Spalten bilden. In den einzelnen Tabellenzellen wird festgehalten, wie viele Untersuchungseinheiten genau auf die jeweilige Kombination aus Zeilen- und Spaltenmerkmal entfallen; diese ausgezählten Zellwerte bilden die beobachteten Häufigkeiten. Im nächsten Rechenschritt bestimmt man für jedes Tabellenfeld die zugehörige erwartete Häufigkeit = (Zeilensumme · Spaltensumme) / Gesamtzahl. Diese Referenzgröße gibt an, welche Zellbesetzung rechnerisch vorläge, wenn zwischen beiden kategorialen Variablen keinerlei Abhängigkeit bestünde. Anschließend wird über alle Tabellenfelder hinweg die Teststatistik berechnet nach der Formel χ² = Summe aller Zellen von (beobachtet minus erwartet)² / erwartet. Durch das Quadrieren und Relativieren am jeweiligen Erwartungswert fließt jede zellbezogene Diskrepanz zwischen empirischer Beobachtung und theoretischem Referenzwert gewichtet in das Gesamtergebnis ein. Weichen die tatsächlichen Zellbesetzungen stark von der Unabhängigkeitsannahme ab, wächst χ² entsprechend an und liefert ein zunehmend deutliches Indiz gegen die Unabhängigkeit der Merkmale. Ob eine einzelne Zelle nach oben oder unten abweicht, bestimmt durch das Vorzeichen der Einzelabweichung noch nicht das Gesamturteil; entscheidend für den statistischen Befund ist allein die über sämtliche Zellen aufsummierte Prüfgröße.
Durchgerechnetes Beispiel: 2x2-Tabelle mit 200 Fällen
Angenommen, 200 Befragte werden nach Wohnort (Stadt/Land) und Hauptverkehrsmittel (ÖPNV/Auto) gefragt. Beobachtet: Stadt 60 ÖPNV und 40 Auto, Land 30 ÖPNV und 70 Auto. Die Zeilensummen betragen jeweils 100, die Spaltensummen 90 (ÖPNV) und 110 (Auto).
| ÖPNV | Auto | Summe | |
|---|---|---|---|
| Stadt | 60 (erwartet 45) | 40 (erwartet 55) | 100 |
| Land | 30 (erwartet 45) | 70 (erwartet 55) | 100 |
| Summe | 90 | 110 | 200 |
Die erwarteten Werte ergeben sich aus (100 · 90) / 200 = 45 und (100 · 110) / 200 = 55. Daraus folgt χ² = (60 minus 45)² / 45 + (40 minus 55)² / 55 + (30 minus 45)² / 45 + (70 minus 55)² / 55 = 5,00 + 4,09 + 5,00 + 4,09 = 18,18. Bei df = (2 minus 1) · (2 minus 1) = 1 liegt der kritische Wert für das 5-Prozent-Niveau bei 3,84. Da 18,18 deutlich darüber liegt, wird die Unabhängigkeitsannahme verworfen.
Die Stärke des Zusammenhangs berechnest du bei einer Vierfeldertafel mit Cramérs V = Wurzel aus (χ² / N) = Wurzel aus (18,18 / 200) = 0,30. Das entspricht einem mittleren Zusammenhang. Im Ergebnisteil berichtest du beides zusammen, etwa so: χ²(1) = 18,18; p < 0,001; V = 0,30; N = 200. Beachte, dass dieselben Anteile (60 % gegen 30 %) bei nur 20 Befragten ein χ² von 1,82 ergäben und damit nicht signifikant wären: Die Fallzahl entscheidet mit.
Testergebnis richtig deuten: Freiheitsgrade, p-Wert und Effektstärke
Für sich genommen lässt ein berechneter χ²-Wert noch keine unmittelbare Aussage über die statistische Bedeutsamkeit zu. Um die Prüfgröße in einer Kreuztabelle fachgerecht einzuordnen, werden neben dem vorab festgelegten Signifikanzniveau zwingend die Freiheitsgraden entsprechenden Verteilungsparameter nach der Beziehung df = (Zeilen minus 1) · (Spalten minus 1) herangezogen. Diese Kenngröße leitet sich direkt aus der Anzahl der Zeilen- und Spaltenkategorien der jeweiligen Kontingenztafel ab und bestimmt den Verlauf der zugrunde liegenden Prüfverteilung. Unterschreitet der daraus ermittelte p-Wert die zuvor definierte Signifikanzschwelle, widersprechen die empirischen Daten der Nullhypothese voneinander unabhängiger Variablen. Allerdings gibt ein statistisch signifikantes Resultat noch keine Auskunft darüber, wie eng die beiden Merkmale inhaltlich gekoppelt sind. Um diese Stärke der Beziehung quantitativ abzubilden, wird in der Ergebnisdarstellung ergänzend das Zusammenhangsmaß Cramérs V ausgewiesen. Eine methodisch saubere Auswertung hält daher stets zwei Ebenen auseinander: einerseits die Entscheidung, ob die Stichprobendaten gegen Unabhängigkeit sprechen, und andererseits die Bewertung, wie stark der gefundene Zusammenhang tatsächlich ausgeprägt ist.
Wichtige Voraussetzungen vor der Durchführung und Auswertung prüfen
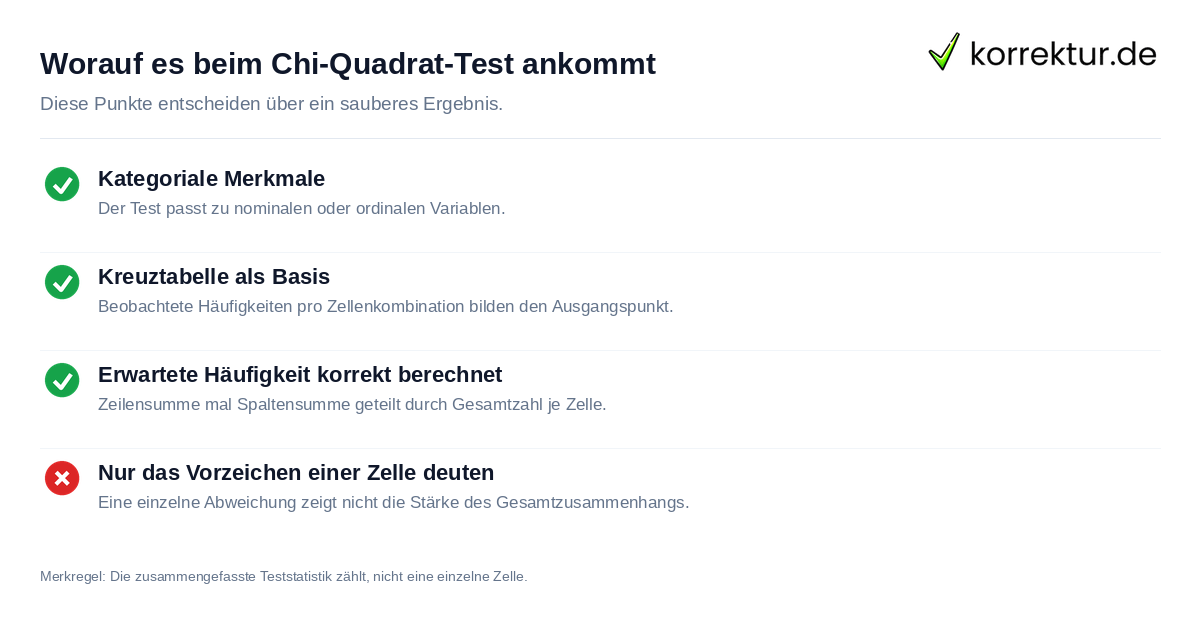
Bevor das Testergebnis inhaltlich ausgewertet wird, ist zu kontrollieren, ob alle methodischen Anwendungsbedingungen erfüllt sind. Als grundlegende Bedingung verlangt das Verfahren unabhängige Beobachtungen, sodass die Merkmalszuordnung einer Untersuchungseinheit keinesfalls beeinflussen darf, in welche Zelle ein anderer Fall gelangt. Darüber hinaus setzt die klassische asymptotische χ²-Approximation voraus, dass die rechnerisch erwarteten Zellbesetzungen eine ausreichende Mindestgröße erreichen. In der statistischen Praxis dient hierfür eine bewährte Faustregel als Maßstab: In mindestens 80 % aller Tabellenzellen muss der erwartete Wert bei wenigstens 5 liegen, während gleichzeitig in keiner einzigen Zelle eine erwartete Häufigkeit unterhalb von 1 auftreten darf. Entscheidend für dieses Kriterium sind ausdrücklich die erwarteten Häufigkeiten der einzelnen Zellen und nicht allein die Gesamtgröße der Stichprobe. Werden diese Schwellenwerte verletzt, empfiehlt sich abhängig von der Dimension der Tabelle und der konkreten Untersuchungsfrage der Wechsel auf ein exaktes oder simulationsgestütztes Testverfahren; speziell bei Vierfeldertafeln bietet sich hierfür der exakte Test nach Fisher als verlässliche Alternative an. Diese Methodenentscheidung gehört zwingend an den Beginn der Analyse, noch bevor ein p-Wert inhaltlich interpretiert wird.
Häufige Fehlerquellen bei Berechnung, SPSS-Auswertung und Bericht vermeiden
In wissenschaftlichen Arbeiten führen wiederkehrende Anwendungsfehler schnell dazu, dass statistische Befunde an Aussagekraft verlieren. Ein klassischer Fallstrick besteht darin, den Chi-Quadrat-Test bei zu geringen erwarteten Zellbesetzungen zu verwenden, ohne zu prüfen, ob die asymptotische Approximation trägt. Genauso irreführend ist der Kurzschluss, einen signifikanten Befund mit einem starken Zusammenhang gleichzusetzen, denn es gilt: Signifikanz ist nicht Effektstärke. Die Berechnung muss zwingend auf absoluten Fallzahlen beruhen, weil Prozentangaben ohne Stichprobenumfang keine gültige Teststatistik erlauben. Auch bei der Deutung ist Zurückhaltung geboten: Ein signifikanter Befund widerlegt die Unabhängigkeitsannahme, belegt aber keine Ursache-Wirkungs-Beziehung. Zwei weitere typische Fehler: mehrere Kategorien so lange zusammenlegen, bis der Test signifikant wird, und df falsch bestimmen, etwa df = N minus 1 statt df = (Zeilen minus 1) · (Spalten minus 1). Wer in SPSS auswertet, ruft die Berechnung über „Kreuztabellen“ auf, hakt unter „Zellen“ die erwarteten Häufigkeiten an und liest die Fußnote zur Anzahl der Zellen mit erwarteter Häufigkeit unter 5 mit. Ein fachkundiges Lektorat hilft anschließend, die Kennwerte sprachlich präzise und formal konsistent darzustellen.
Um bereits bei der Studienplanung das passende Testverfahren für die eigenen Variablen auszuwählen, bietet unser Beitrag Skalenniveaus erklärt eine verlässliche Einordnung der verschiedenen Messniveaus. Wer darüber hinaus nachvollziehen möchte, wie präzise sich Kennwerte aus Stichproben eingrenzen lassen, findet im Ratgeber Konfidenzintervall berechnen weiterführende Grundlagen zur statistischen Schätzung. Für die vorbereitende Aufbereitung und übersichtliche Zusammenfassung von Häufigkeitsdaten empfiehlt sich ein Blick in die deskriptive Statistik, während unser zentraler Statistik- und SPSS-Hub zahlreiche weitere Auswertungsmethoden und Praxisanleitungen übersichtlich zusammenführt. Steht die Fertigstellung deiner Arbeit bevor, sorgt ein professionelles Korrekturlesen dafür, dass Ergebnisberichte, Tabellenbeschriftungen und wissenschaftliche Formulierungen sprachlich wie formal überzeugen.
Arten des Chi-Quadrat-Tests im Überblick
Unter dem Namen Chi-Quadrat-Test laufen drei Varianten, die dieselbe Prüfgröße nutzen, aber verschiedene Fragen beantworten. Das obige Beispiel gehört zum Unabhängigkeitstest.
| Variante | Fragestellung | Beispiel | Freiheitsgrade |
|---|---|---|---|
| Unabhängigkeitstest | Hängen zwei Merkmale einer Stichprobe zusammen? | Wohnort und Verkehrsmittel | (Zeilen minus 1) · (Spalten minus 1) |
| Homogenitätstest | Ist ein Merkmal in mehreren Gruppen gleich verteilt? | Therapieerfolg in drei Behandlungsgruppen | (Zeilen minus 1) · (Spalten minus 1) |
| Anpassungstest | Passt die Verteilung eines Merkmals zu einer erwarteten Verteilung? | Würfel auf Fairness prüfen | Kategorien minus 1 |
Rechnerisch unterscheiden sich Unabhängigkeits- und Homogenitätstest nicht; sie unterscheiden sich in der Erhebung. Beim Unabhängigkeitstest wird eine Stichprobe nach zwei Merkmalen ausgewertet, beim Homogenitätstest sind die Gruppen vorab festgelegt.
Beispiel für den Anpassungstest: Ist der Würfel fair?
Ein Würfel wird 60-mal geworfen. Bei einem fairen Würfel erwartest du für jede Augenzahl 10 Würfe. Beobachtet wurden die Augenzahlen 1 bis 6 mit 8, 12, 9, 11, 14 und 6 Würfen. Daraus folgt χ² = (8 minus 10)² / 10 + (12 minus 10)² / 10 + (9 minus 10)² / 10 + (11 minus 10)² / 10 + (14 minus 10)² / 10 + (6 minus 10)² / 10 = (4 + 4 + 1 + 1 + 16 + 16) / 10 = 4,20. Mit df = 6 minus 1 = 5 liegt der kritische Wert bei 11,07. Da 4,20 darunter liegt, gibt es keinen Hinweis darauf, dass der Würfel unfair ist.
Kritische Werte der Chi-Quadrat-Verteilung
Statt des p-Werts kannst du die Prüfgröße mit dem kritischen Wert aus der Chi-Quadrat-Tabelle vergleichen. Ist χ² größer als der kritische Wert zu deinen Freiheitsgraden, ist das Ergebnis auf dem gewählten Niveau signifikant.
| df | α = 0,05 | α = 0,01 |
|---|---|---|
| 1 | 3,84 | 6,63 |
| 2 | 5,99 | 9,21 |
| 3 | 7,81 | 11,34 |
| 4 | 9,49 | 13,28 |
| 5 | 11,07 | 15,09 |
Sind die erwarteten Häufigkeiten zu klein, etwa in einer 2x2-Tabelle mit sehr wenigen Fällen, weichst du auf den exakten Test nach Fisher aus, der ohne die Näherung an die Chi-Quadrat-Verteilung auskommt.
So zitierst du diese Seite
Stand: 13. November 2026korrektur.de. (2026, 13. November). Chi-Quadrat-Test: Formel, Beispiel, Voraussetzungen. korrektur.de. https://korrektur.de/chi-quadrat-test-erklaert
„Chi-Quadrat-Test: Formel, Beispiel, Voraussetzungen.“ korrektur.de, 13. Nov. 2026, korrektur.de/chi-quadrat-test-erklaert. Zugriff 31. Okt. 2026.
korrektur.de (2026) Chi-Quadrat-Test: Formel, Beispiel, Voraussetzungen. Verfügbar unter: https://korrektur.de/chi-quadrat-test-erklaert (Zugriff: 31. Oktober 2026).
korrektur.de. „Chi-Quadrat-Test: Formel, Beispiel, Voraussetzungen.“ Zuletzt geändert 13. November 2026. https://korrektur.de/chi-quadrat-test-erklaert.
korrektur.de. Chi-Quadrat-Test: Formel, Beispiel, Voraussetzungen [online]. 2026 [Zugriff am 31.10.2026]. Verfügbar unter: https://korrektur.de/chi-quadrat-test-erklaert