Inferenzstatistik in SPSS: Signifikanztests und p-Wert anwenden
 Fachlich geprüft von Benjamin Lohrer, Lektor bei korrektur.de · Stand: 14. November 2026
Warum die Inferenzstatistik über die Stichprobe hinausgeht
In empirischen Untersuchungen klärt die Inferenzstatistik eine entscheidende Kernfrage: Lassen sich gewonnene Stichprobenergebnisse belastbar auf die gesamte Grundgesamtheit übertragen? Wer verlässliche Schlüsse ziehen möchte, muss mathematische Modelle und Hypothesentests methodisch präzise anwenden. Während die deskriptive Statistik Kennwerte wie Mittelwerte und Streuungsmaße lediglich zusammenfassend abbildet, ermöglicht die schließende Statistik daraus eine fundierte Verallgemeinerung. Dieser Leitfaden erläutert zentrale Signifikanztests, ordnet den p-Wert fachlich ein und demonstriert die Umsetzung in SPSS anhand eines nachvollziehbaren Beispiels.
Grundprinzipien und Aufgaben der Inferenzstatistik
Als induktiver Zweig der Datenanalyse nutzt die Inferenzstatistik mathematische Wahrscheinlichkeitsmodelle, um von einer begrenzten Stichprobe auf übergeordnete Populationen zu schließen. Ob solche Rückschlüsse wissenschaftlich tragfähig sind, bestimmen vor allem ein sauberes Untersuchungsdesign, eine unverzerrte Stichprobenziehung sowie erfüllte Verteilungsannahmen. Anstelle reiner Beschreibungen prüft das Verfahren systematisch, inwiefern empirische Beobachtungen mit einer theoretischen Nullhypothese übereinstimmen. Typische Instrumente bilden Konfidenzintervalle, Regressionsanalysen und klassische Signifikanztests. Statistische Tests quantifizieren dabei stochastische Unsicherheiten, kompensieren jedoch niemals methodische Mängel bei der Datenerhebung.

Inferenzstatistik im Vergleich zur deskriptiven Statistik
Eine fundierte deskriptive Statistik ordnet das vorliegende Datenmaterial und bereitet Lage- sowie Streuungsmaße wie Median, Mittelwert oder Standardabweichung übersichtlich in Tabellen und Diagrammen auf. Darauf aufbauend untersucht die schließende Statistik, ob beobachtete Effekte über den Datensatz hinaus Gültigkeit besitzen oder bloß zufällig entstanden sind. Beide Ansätze greifen nahtlos ineinander: Erst wenn Kennwerte präzise dokumentiert sind, folgen statistische Prüfverfahren zur Verallgemeinerung. Reine Deskription genügt nicht für populationsbezogene Aussagen, da Repräsentativität und Modellannahmen den Ausschlag geben. Eine saubere Trennung beider Analyseschritte erhöht die Nachvollziehbarkeit wissenschaftlicher Arbeiten erheblich.
Logik von Signifikanztests und Bedeutung des p-Werts
Im Zentrum induktiver Auswertungen steht das systematische Prüfen theoretischer Annahmen über eine formulierte Nullhypothese, welche üblicherweise das Fehlen eines Unterschieds oder Zusammenhangs postuliert. Der ermittelte p-Wert beziffert unter der Annahme dieser Nullhypothese die Wahrscheinlichkeit, Stichprobendaten zu erhalten, die mindestens so stark von der Erwartung abweichen wie die beobachteten Werte. Unterschreitet dieser Wert die vorab definierte Irrtumswahrscheinlichkeit von 0,05, gilt der Befund definitionsgemäß als statistisch signifikant. Dieser formalisierte Ablauf folgt der Logik etablierter Verfahren wie dem klassischen Hypothesentest. Weil Signifikanzen allein noch keine Auskunft über Relevanz geben, vervollständigen Konfidenzintervalle und standardisierte Effektmaße die Interpretation.
Fehlinterpretationen vermeiden und den p-Wert korrekt lesen
In wissenschaftlichen Arbeiten treten beim Beurteilen statistischer Prüfergebnisse regelmäßig Missverständnisse auf. Der p-Wert beziffert nicht die Wahrscheinlichkeit für das Zutreffen der Nullhypothese und spiegelt keinesfalls die inhaltliche Stärke eines Zusammenhangs wider. Sehr kleine Werte verdeutlichen lediglich, dass die empirischen Daten schwer mit dem Nullmodell vereinbar sind. Für einen transparenten Befundbericht empfiehlt sich stets die kombinierte Darstellung von Signifikanzniveau, Konfidenzintervall und standardisierter Effektstärke. Vor allem bei umfangreichen Stichproben werden selbst minimale Differenzen schnell statistisch signifikant, weshalb statistische Signifikanz und praktische Relevanz streng getrennt zu bewerten sind.

Inferenzstatistik in SPSS: Signifikanztests praktisch berechnen
In der Benutzeroberfläche von SPSS lassen sich Signifikanztests unkompliziert über das Menü Analysieren aufrufen, beispielsweise Mittelwertvergleiche mittels t-Test oder Zusammenhangsanalysen im Bereich Korrelation. Den berechneten p-Wert gibt die Software im Ausgabefenster standardmäßig in der Spalte Sig. oder Signifikanz (2-seitig) aus. Trotz der einfachen Bedienung erfordert die Inferenzstatistik in SPSS fundiertes Vorgehen: Vor der Durchführung sollten methodische Voraussetzungen wie Normalverteilung oder Varianzhomogenität sorgfältig geprüft werden. Weiterführende Optionen für getrennte Variablenpaare bietet eine bivariate Auswertung im selben Programmzweig. Bei verletzten Testvoraussetzungen bieten sich nichtparametrische Alternativen oder robuste Schätzverfahren an, damit statistische Tests belastbare und unverfälschte Ergebnisse liefern.
Praxisbeispiel: t-Test in SPSS auswerten und einordnen
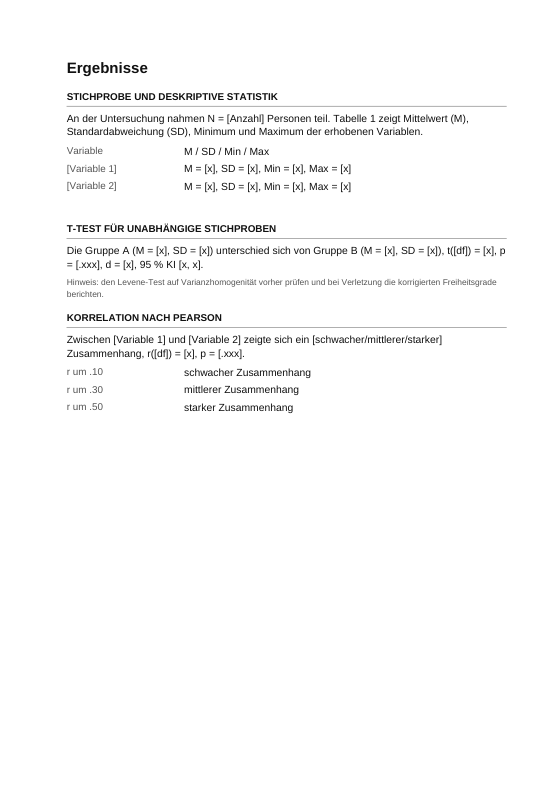
Zur Veranschaulichung dient ein typisches Szenario aus der Abschlussarbeit: Verglichen werden die Klausurnoten zweier unabhängiger Kohorten von jeweils 30 Studierenden. Gruppe A erreicht im arithmetischen Mittel einen Vorsprung von 0,4 Notenpunkten gegenüber Gruppe B. Unter der Voraussetzung annähernd normalverteilter Werte und homogener Varianzen liefert der t-Test in SPSS einen zweiseitigen p-Wert von 0,03. Da dieser Wert unter der festgelegten Signifikanzgrenze von 0,05 liegt, wird die Nullhypothese gleicher Mittelwerte statistisch verworfen. Allerdings belegt dieser Befund allein weder die praktische Relevanz des Effekts noch eine vorbehaltlose Übertragbarkeit. Erst durch das Berechnen von Cohens d, das Ausweisen von Konfidenzintervallen sowie eine kritische Reflexion von Stichprobenauswahl und Untersuchungsaufbau lässt sich das Ergebnis wissenschaftlich überzeugend anwenden und diskutieren.
Für eine ganzheitliche Auswertung empfiehlt sich die methodische Verknüpfung weiterer Schwerpunkte wie deskriptive Statistik, bivariate Statistik sowie vertiefende Modellierungen in SPSS.
So zitierst du diese Seite
Stand: 14. November 2026korrektur.de. (2026, 14. September). Inferenzstatistik in SPSS: Tests und p-Wert. korrektur.de. https://korrektur.de/inferenzielle-statistik-spss
„Inferenzstatistik in SPSS: Tests und p-Wert.“ korrektur.de, 14. Sept. 2026, korrektur.de/inferenzielle-statistik-spss. Zugriff 31. Okt. 2026.
korrektur.de (2026) Inferenzstatistik in SPSS: Tests und p-Wert. Verfügbar unter: https://korrektur.de/inferenzielle-statistik-spss (Zugriff: 31. Oktober 2026).
korrektur.de. „Inferenzstatistik in SPSS: Tests und p-Wert.“ Zuletzt geändert 14. September 2026. https://korrektur.de/inferenzielle-statistik-spss.
korrektur.de. Inferenzstatistik in SPSS: Tests und p-Wert [online]. 2026 [Zugriff am 31.10.2026]. Verfügbar unter: https://korrektur.de/inferenzielle-statistik-spss