Clusteranalyse in der empirischen Abschlussarbeit anwenden
 Fachlich geprüft von Benjamin Lohrer, Lektor bei korrektur.de · Stand: 18. Oktober 2026
Warum die Clusteranalyse ähnliche Objekte sinnvoll gruppiert
Die Clusteranalyse ist ein strukturentdeckendes Verfahren der multivariaten Statistik: Sie teilt Fälle (Personen, Produkte, Regionen) anhand mehrerer gemessener Merkmale in Gruppen, sodass sich Fälle innerhalb eines Clusters möglichst ähnlich und die Cluster untereinander möglichst unähnlich sind. Gerechnet wird über ein Abstandsmaß, meist die quadrierte euklidische Distanz; die Gruppen entstehen entweder hierarchisch (Ward, Single Linkage, Complete Linkage) oder partitionierend (k-Means). Du gibst keine abhängige Variable vor, sondern liest die Gruppen aus den Daten heraus und benennst sie anschließend über ihre Mittelwertprofile. Für Studierende, die eine Clusteranalyse in der empirischen Abschlussarbeit anwenden, lohnt sie sich immer dann, wenn noch keine Gruppeneinteilung im Datensatz vorliegt.
Kostenlos herunterladen
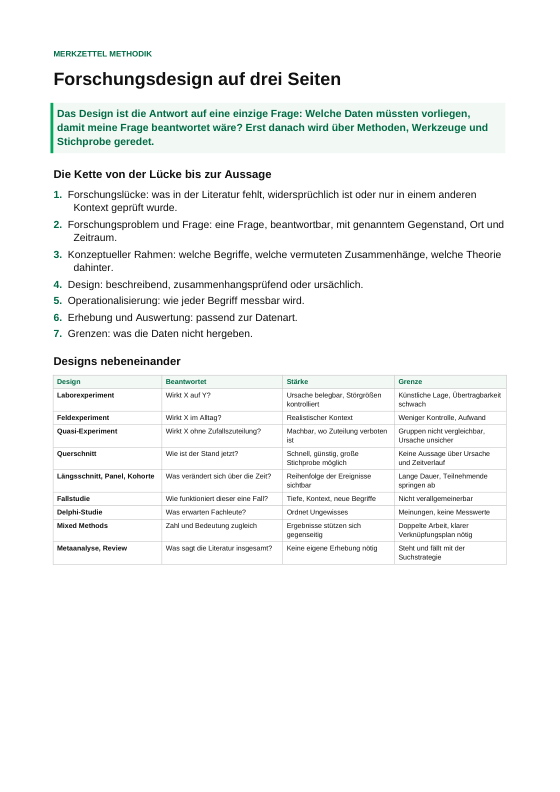
Forschungsdesign wählen: Merkzettel für den Aufbau einer Studie
Die Clusteranalyse als Verfahren, begleitet von der Kette von der Forschungslücke bis zur Aussage, neun Designs mit Stärke und Grenze, den Wegen der Erhebung, der Operationalisierung in sechs Schritten, den Gütekriterien und einem Raster für das eigene Design.
Ein kurzes Rechenbeispiel macht das Prinzip greifbar: Zwei Befragte haben auf zwei standardisierten Skalen die Werte (1,0; 0,5) und (0,8; 0,7). Die quadrierte euklidische Distanz beträgt (1,0 minus 0,8)² + (0,5 minus 0,7)² = 0,04 + 0,04 = 0,08. Ein dritter Fall mit (minus 1,2; 0,6) liegt zum ersten Fall bei (1,0 + 1,2)² + (0,5 minus 0,6)² = 4,84 + 0,01 = 4,85 und landet deshalb in einem anderen Cluster. Genau solche paarweisen Abstände stehen in der Distanzmatrix, aus der jeder Algorithmus seine Fusionen ableitet.
Grundprinzip und Forschungsziel der Clusteranalyse verstehen
Methodisch arbeitet die Clusteranalyse rein explorativ und kommt vollständig ohne eine vorab festgelegte abhängige Variable aus. Anders als bei einer Regressionsanalyse geht es nicht darum, Ursache-Wirkungs-Beziehungen zu testen oder Zielgrößen vorherzusagen, sondern bislang unbekannte Muster und homogene Teilgruppen im Datenbestand sichtbar zu machen. Ähnliche Objekte werden dabei so sinnvoll gruppiert, dass die interne Homogenität innerhalb jedes einzelnen Clusters möglichst hoch ausfällt und zugleich eine klare externe Heterogenität zwischen den verschiedenen Clustern entsteht.
In empirischen Arbeiten dient dieser strukturentdeckende Ansatz häufig dazu, charakteristische Kundensegmente, unterschiedliche Lerntypen oder spezifische Nutzergruppen aus Befragungs- oder Beobachtungsdaten abzuleiten. Statt bestehende Kategorien nur zu überprüfen, generiert die Analyse neue empirische Typologien direkt aus den Merkmalsprofilen der untersuchten Fälle. Wer sich darüber hinaus einen systematischen Überblick über angrenzende Auswertungsverfahren verschaffen möchte, findet im Statistik- und SPSS-Hub hilfreiche Grundlagenartikel und praxisnahe Anleitungen für das Studium.

Hierarchische und partitionierende Verfahren im Vergleich
In der Forschungspraxis lassen sich innerhalb der Clusteranalyse im Wesentlichen zwei große Verfahrensfamilien unterscheiden. Agglomerative beziehungsweise hierarchische Ansätze erzeugen Schritt für Schritt eine verzweigte Baumstruktur, indem sie zunächst einzelne Fälle betrachten und die jeweils ähnlichsten Einheiten sukzessive zu größeren Gruppen vereinigen. Zu den bekanntesten Varianten gehören Single Linkage, Complete Linkage sowie das Ward-Verfahren, wobei Letzteres besonders ausgewogene Gruppengrößen mit geringer Streuung im Inneren begünstigt.
- Ward-Verfahren: führt auf jeder Verschmelzungsstufe genau jene Gruppen zusammen, bei denen die Fehlerquadratsumme beziehungsweise die Varianz innerhalb der Cluster am wenigsten ansteigt.
- Single Linkage: orientiert sich am kürzesten Abstand zwischen einzelnen Fällen zweier Gruppen, neigt dadurch zur Bildung langer Ketten und eignet sich gut zum Aufspüren von Ausreißern.
- Complete Linkage: zieht die größte Distanz zwischen den jeweiligen Gruppenmitgliedern heran und erzeugt dadurch eher kleine, in sich geschlossene und kompakte Cluster.
Demgegenüber stehen partitionierende Algorithmen wie k-Means, bei denen die gewünschte Clusteranzahl vorab vorgegeben wird und die Fälle durch wiederholte Neuberechnung der Clusterzentren iterativ umgruppiert werden, bis eine optimale Partition erreicht ist. In Abschlussarbeiten hat sich häufig ein zweistufiges Vorgehen bewährt: Zuerst grenzt ein hierarchisches Verfahren eine sinnvolle Zahl an Clustern ein, bevor k-Means die endgültige Zuordnung der Untersuchungseinheiten präzisiert.
Geeignete Distanzmaße auswählen und Variablen standardisieren
Damit ein Algorithmus beurteilen kann, wie stark sich Fälle ähneln oder voneinander abweichen, erfordert jede Clusteranalyse ein mathematisches Proximitäts- oder Distanzmaß. Diese Methodenwahl beeinflusst die spätere Gruppenbildung maßgeblich und muss zwingend auf das Skalenniveau der erhobenen Variablen sowie auf den gewählten Fusionsalgorithmus abgestimmt sein. Liegen metrisch skalierte Merkmale vor, greifen Forschende meist auf die euklidische Distanz oder ihre quadrierte Form zurück, während die Manhattan-Distanz je nach Verteilungsform und Datenstruktur eine sinnvolle Alternative darstellt.
| Distanzmaß | Eignung |
|---|---|
| Euklidische Distanz | metrische Variablen, häufig verwendetes Maß |
| Quadrierte euklidische Distanz | bei Ward häufig verwendete Wahl |
| Manhattan-Distanz | Alternative bei metrischen Variablen; die Ausreißerempfindlichkeit ist datenabhängig |
Werden Merkmale mit voneinander abweichenden Skalenbereichen oder Maßeinheiten gemeinsam ausgewertet, empfiehlt sich vorab dringend eine Standardisierung der Werte, damit Variablen mit großer numerischer Spannweite die Abstandsberechnung nicht künstlich dominieren. Eine vorgeschaltete deskriptive Statistik hilft dabei, Lage- und Streuungsmaße wie Mittelwerte, Standardabweichungen sowie mögliche Extremwerte vor dem eigentlichen Rechenlauf sorgfältig zu kontrollieren.
Praktischer Ablauf einer Clusteranalyse in SPSS
In SPSS findest du die Clusteranalyse unter Analysieren > Klassifizieren. Dort stehen drei Einträge: Hierarchische Clusteranalyse, Clusterzentrenanalyse (das ist k-Means) und Two-Step-Cluster für gemischte Skalenniveaus. Konkret gehst du so vor:
- Standardisieren: Analysieren > Deskriptive Statistiken > Deskriptive Statistik, Häkchen bei "Standardisierte Werte als Variable speichern". SPSS legt die z-Werte mit vorangestelltem Z an, etwa Zzufriedenheit.
- Hierarchisch rechnen: Die Z-Variablen in "Variablen" ziehen, unter "Methode" als Clustermethode Ward-Linkage und als Maß die quadrierte euklidische Distanz wählen.
- Ausgabe anfordern: Unter "Diagramme" das Dendrogramm aktivieren, unter "Statistiken" die Zuordnungsübersicht und die Bandbreite der Lösungen, etwa 2 bis 6 Cluster.
- Clusterzahl ablesen: Im Sprung der Koeffizienten der Zuordnungsübersicht und im langen Ast des Dendrogramms, nicht nach Augenmaß am Rand der Grafik.
- k-Means anschließen: Clusterzentrenanalyse mit der eben gefundenen Zahl, unter "Speichern" die Clusterzugehörigkeit als neue Variable ablegen.
- Profilieren: Analysieren > Mittelwerte vergleichen > Mittelwerte, Z-Variablen als abhängige Liste, die gespeicherte Clustervariable als unabhängige. Daraus entsteht die Profiltabelle.
Bereits bei der Konzeption einer Bachelorarbeit oder Masterarbeit gibt das Untersuchungsdesign vor, welche Variablen überhaupt erhoben werden und inwiefern eine Typenbildung zur Beantwortung der Forschungsfrage beiträgt. Je sorgfältiger die Datenbereinigung und Variablenauswahl im Vorfeld dokumentiert werden, desto belastbarer fallen die späteren Clusterlösungen aus.

Clusteranzahl fundiert bestimmen und Ergebnisse interpretieren
Zu den wichtigsten methodischen Entscheidungen jeder Clusteranalyse gehört es, die optimale Anzahl an Clustern nachvollziehbar herzuleiten. Bei hierarchischen Verfahren liefert das Dendrogramm eine anschauliche Grafik der schrittweisen Gruppenverschmelzung, während sprunghafte Anstiege der Fusionsdistanzen in der Zuordnungsübersicht markieren, ab welchem Punkt recht unähnliche Gruppen zusammengelegt würden. Kommt das k-Means-Verfahren zum Einsatz, bietet das Elbow-Kriterium eine bewährte Orientierungshilfe: Trägt man die Fehlerquadratsumme gegen verschiedene Clusterzahlen ab, deutet ein sichtbarer Knick im Kurvenverlauf auf eine geeignete Lösung hin. Dennoch sollte die Wahl niemals rein mechanisch erfolgen, sondern immer durch Stabilitätstests und eine überzeugende fachliche Interpretierbarkeit abgesichert werden.
So liest du die Zuordnungsübersicht praktisch: Steigen die Koeffizienten der letzten Schritte etwa von 48, 55 und 61 auf plötzlich 140, dann wurden in diesem letzten Schritt zwei sehr unähnliche Gruppen verschmolzen. Der Sprung liegt vor der Fusion von drei auf zwei Cluster, also sprechen die Daten für eine Drei-Cluster-Lösung. Im Dendrogramm entspricht das einem waagerechten Schnitt dort, wo die Äste besonders lang sind, also lange nichts mehr zusammenwächst.
Clusterprofile mit Zahlen beschreiben
Die Profilierung läuft über eine Tabelle mit den Mittelwerten je Cluster und Variable. Ein Beispiel aus einer Befragung zum Lernverhalten mit z-standardisierten Werten: Cluster 1 zeigt hohe Werte bei Zeitplanung (+0,9) und niedrige bei Prüfungsangst (minus 0,7), Cluster 2 umgekehrt (minus 0,8 und +1,1), Cluster 3 liegt bei allen Merkmalen nahe null. Daraus werden sprechende Namen wie strukturierte Lernende, belastete Lernende und unauffällige Mitte. Nenne zusätzlich die Clustergrößen, denn ein Cluster mit vier von 280 Fällen trägt keine Interpretation, sondern ist meist eine Ausreißergruppe.
Für den Ergebnisteil berichtest du Verfahren, Distanzmaß, Standardisierung, Clusterzahl samt Begründung, Clustergrößen und die Mittelwertprofile. Ein Satz zur Stabilität gehört dazu, etwa dass eine zweite k-Means-Lösung mit anderen Startzentren dieselbe Zuordnung für den Großteil der Fälle ergibt. Im Diskussionsteil führst du die Profile auf den theoretischen Rahmen zurück, statt sie nur zu benennen.
Typische Anwendungsfelder, Abgrenzung und häufige Fehlerquellen
Klassische Einsatzgebiete für eine Clusteranalyse reichen von der Zielgruppen- und Marktsegmentierung im Marketing über die empirische Typenbildung in den Sozialwissenschaften bis hin zur Bündelung von Teilnehmenden anhand ähnlicher Verhaltens- oder Einstellungsmuster. Im Zusammenspiel der qualitativen und quantitativen Forschung kann das Verfahren zudem genutzt werden, um qualitativ gewonnene Falltypen anhand größerer Stichproben quantitativ zu untermauern. Wichtig für den Methodenteil ist die präzise Abgrenzung zur Faktorenanalyse: Während eine Faktorenanalyse korrelierende Variablen zu übergeordneten Dimensionen verdichtet, fasst die Clusteranalyse untersuchte Personen, Fälle oder Objekte zu homogenen Gruppen zusammen.
Häufige Fallstricke in studentischen Arbeiten entstehen vor allem dann, wenn Merkmale trotz unterschiedlicher Skalen unstandardisiert einfließen, ein zum Skalenniveau unpassendes Distanzmaß gewählt wird oder die Clusteranzahl ohne transparente Kriterien festgelegt wird. Konkret: Fließen Monatseinkommen in Euro und Zufriedenheit auf einer Skala von 1 bis 5 gemeinsam ein, bestimmt praktisch allein das Einkommen die Abstände, weil seine Spannweite tausendfach größer ist. Ebenso können stark miteinander korrelierende Variablen zu einer Doppelgewichtung derselben Dimension führen, etwa wenn du drei nahezu gleich formulierte Zufriedenheitsitems alle als Clustervariablen aufnimmst. Auch die Fallreihenfolge ist relevant: k-Means hängt von den Startzentren ab, deshalb solltest du die Lösung mit einer anderen Startkonfiguration oder einer geteilten Stichprobe auf Stabilität prüfen. Wenn du deine Auswertung verschriftlicht hast und den Text sprachlich, stilistisch sowie formal absichern möchtest, unterstützt dich unser Korrekturlesen und Lektorat.
Weiterführende Themen rund um multivariate Auswertungsmethoden umfassen die Faktorenanalyse, methodische Grundlagen für qualitative sowie quantitative Forschung und praxisnahe Hilfestellungen zu Statistik und SPSS.
So zitierst du diese Seite
Stand: 18. Oktober 2026korrektur.de. (2026, 18. Oktober). Clusteranalyse einfach erklärt für Studierende. korrektur.de. https://korrektur.de/clusteranalyse
„Clusteranalyse einfach erklärt für Studierende.“ korrektur.de, 18. Okt. 2026, korrektur.de/clusteranalyse. Zugriff 31. Okt. 2026.
korrektur.de (2026) Clusteranalyse einfach erklärt für Studierende. Verfügbar unter: https://korrektur.de/clusteranalyse (Zugriff: 31. Oktober 2026).
korrektur.de. „Clusteranalyse einfach erklärt für Studierende.“ Zuletzt geändert 18. Oktober 2026. https://korrektur.de/clusteranalyse.
korrektur.de. Clusteranalyse einfach erklärt für Studierende [online]. 2026 [Zugriff am 31.10.2026]. Verfügbar unter: https://korrektur.de/clusteranalyse