Plagiatscan online: Ablauf, Ergebnisse richtig lesen und Grenzen kennen
Plagiatscan online: Ablauf, Ergebnis und Grenzen
Wer seine Arbeit vor der Abgabe auf Plagiate prüfen will, findet online verschiedene Scan-Werkzeuge. Diese Seite erklärt, wie der Scan abläuft, was der Bericht wirklich aussagt und wo seine Grenzen liegen.
Was ein Plagiatscan online prüft und welche Formen er findet
Ein Plagiatscan online vergleicht den hochgeladenen Text mit Internetquellen und Datenbanken und markiert übereinstimmende Stellen. Das Ergebnis ist kein automatisches Plagiaturteil, sondern eine Auflistung von Fundstellen, die anschließend bewertet werden müssen.
Die Hochschulbibliothek der HTW Berlin beschreibt in ihrer Dokumentation zur früheren Plagiatssoftware, dass diese auf klassische Plagiatformen ausgelegt war. Dazu gehören direkt kopierte Passagen (copy and paste), geringfügig veränderte Formulierungen (shake and paste) sowie wörtliche Übernahmen aus Internetquellen. Ein Scan erkennt also Stellen, an denen ein Text mit bekannten Quellen übereinstimmt, ordnet aber nicht ein, ob die Übernahme beabsichtigt, versehentlich oder korrekt zitiert war.
Die Turnitin-Anleitung der Bibliothek der Freien Universität Bozen hält ausdrücklich fest, dass die Software selbst nicht darüber entscheidet, ob eine Arbeit plagiiert wurde. Sie zeigt Problembereiche auf, die eine Lehrperson oder die Schreibende in einem weiteren Schritt bewerten muss. Die Frage, ob eine markierte Stelle zulässig ist, beantwortet das Programm nicht.
Plagiat-Scan ist deshalb als Suchwerkzeug zu verstehen, nicht als Entscheidungsinstanz. Der Bericht liefert Anhaltspunkte für eine eigene kritische Durchsicht der Arbeit. Ein Prozentwert, der im Bericht erscheint, sagt nichts darüber aus, ob eine Arbeit akzeptiert wird oder nicht.
Wer die eigene Arbeit vor der Abgabe prüfen will, sollte deshalb nicht allein auf den Bericht vertrauen. Ein Blick in die Anbieterseite des jeweiligen Scans zeigt, welche Textarten dort als Übereinstimmung markiert werden können. Deshalb ergänzt der Scan die eigene sorgfältige Prüfung, ersetzt sie aber nicht.
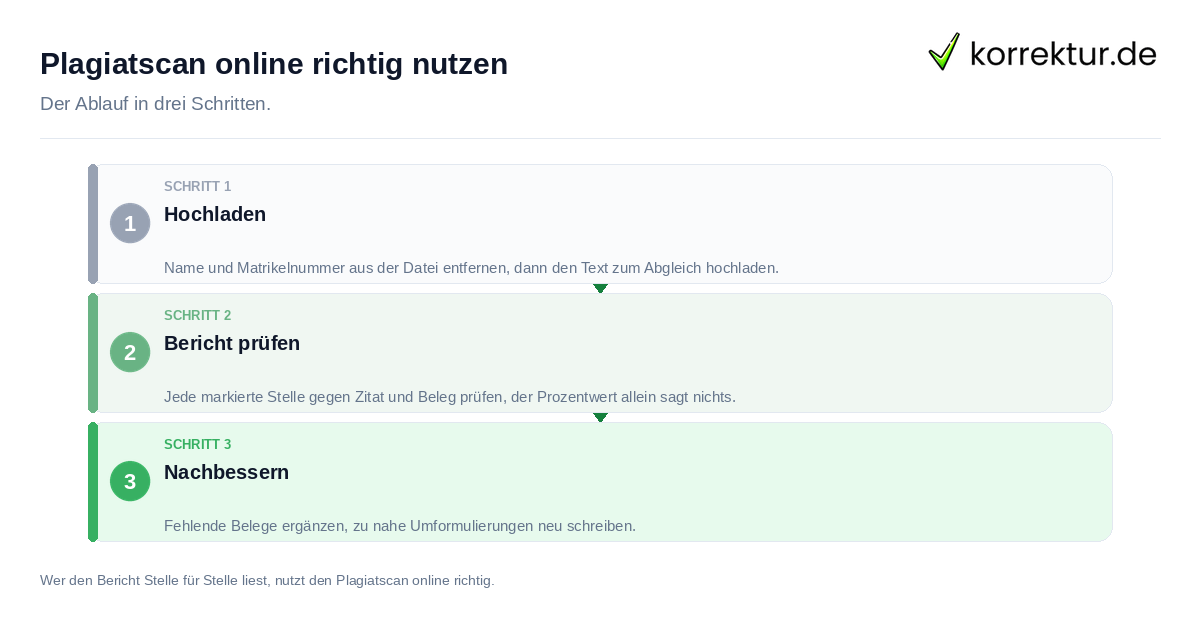
Schritt für Schritt: So läuft ein Plagiatscan online ab
Plagiatsprüfung online folgt einem klar gegliederten Ablauf, den man in fünf Schritte unterteilen kann. Wer diesen Ablauf kennt, liest den Bericht hinterher richtig ein.
- Text als Datei oder als direkt eingefügte Kopie beim Dienst hochladen.
- Den Abgleich mit der Datenbank abwarten, bis der Bericht fertiggestellt ist.
- Den Bericht mit den markierten Stellen und dem ausgewiesenen Prozentwert öffnen.
- Jede markierte Stelle einzeln gegen das eigene Zitat und den zugehörigen Beleg prüfen.
- Fehlende Belege nachtragen oder Passagen umformulieren, die zu nah am Originalwortlaut geblieben sind.
Die Bibliothek der Freien Universität Bozen erklärt in ihrer Turnitin-Anleitung, dass der Ähnlichkeitsindex (Similarity Score Index) lediglich Problembereiche aufzeigt. Eine Lehrperson muss diese im Rahmen eines umfassenderen Prozesses bewerten, bevor sie einschätzen kann, ob eine Übereinstimmung akzeptabel war. Der Wert allein enthält keine solche Einschätzung.
Dieselbe Anleitung weist auf eine bekannte Fehlerquelle hin: Wer dasselbe Dokument ein zweites Mal hochlädt, kann einen künstlich hohen Wert von etwa 90 bis 100 Prozent erhalten. Ursache ist, dass die Software beim erneuten Upload das neue Dokument mit der bereits gespeicherten ersten Fassung abgleicht. Wer diesen Schritt übersieht, muss die ältere Fassung zunächst von Hand aus dem Vergleich nehmen.
Daraus ergibt sich eine einfache Vorsichtsmaßnahme: Vor einem zweiten Scandurchlauf sollte man in den Einstellungen oder Hinweisen des genutzten Dienstes prüfen, ob die erste hochgeladene Version noch gespeichert ist. Bleibt dieser Schritt aus, kann der Bericht einen Wert ausweisen, der nicht die Übereinstimmung mit fremden Quellen widerspiegelt, sondern den Vergleich mit der eigenen früheren Fassung.
Das Ergebnis des Plagiatscans richtig lesen und einordnen
Kostenlose Plagiatsprüfung und kostenpflichtige Dienste liefern beide einen Bericht mit markierten Stellen und einem Prozentwert. Wer diesen Bericht richtig lesen will, muss verstehen, was jeder Befund bedeutet und welcher nächste Schritt folgt.
Die Turnitin-Anleitung der Bibliothek der Freien Universität Bozen stellt klar, dass der Prozentwert kein Plagiaturteil ist, sondern ein Hinweis, der menschliche Bewertung erfordert. Das bedeutet: Ein hoher Wert zwingt nicht automatisch zur Überarbeitung, und ein niedriger Wert ist kein Freifahrtschein. Jede markierte Stelle verdient eine eigene Beurteilung.
Die HTW Berlin weist in ihrer Dokumentation darauf hin, dass die Software auf wörtliche und leicht veränderte Übernahmen ausgelegt ist. Wer seinen Text sauber mit Belegen versehen hat, sieht trotzdem Treffer. Wer keinen Treffer hat, kann daraus nicht schließen, dass alle Belege korrekt gesetzt sind. Ein Scan findet keine fehlenden Fußnoten, sondern nur Übereinstimmungen mit vorhandenen Texten.
| Befund | Bedeutung | Nächster Schritt |
|---|---|---|
| Markierte Stelle mit Zitat und Beleg | Korrekte Übernahme; Software erkennt Übereinstimmung mit deklarierter Quelle | Keine Änderung erforderlich |
| Markierte Stelle ohne Beleg | Mögliche undeklarierte Übernahme aus einer bekannten Quelle | Beleg nachtragen oder Passage eigenständig umformulieren |
| Markierte Standardformulierung oder Literaturangabe | Formelhafte Wendung oder bibliografischer Eintrag ohne inhaltliches Problem | Prüfen, ob der Bericht einen Ausschluss dieser Stelle erlaubt |
| Sehr hoher Wert nach erneutem Hochladen | Software vergleicht neues Upload mit der gespeicherten ersten Fassung desselben Dokuments | Frühere Version manuell ausschließen und Scan neu starten |
| Kein Treffer | Keine wörtlichen oder leicht veränderten Übereinstimmungen mit bekannten Quellen gefunden | Belege dennoch eigenständig prüfen; fehlende Fußnoten erkennt der Scan nicht |
Einen Schwellenwert, ab dem ein Wert als unbedenklich oder problematisch gilt, nennen die vorliegenden Quellen nicht. Wer wissen möchte, welcher Wert an der eigenen Hochschule als Ausgangspunkt für eine nähere Prüfung gilt, schaut in die Vorgaben der eigenen Prüfungsordnung oder fragt die zuständige Lehrperson.
Grenzen des Scans: KI-Texte erkennen und Datenschutz beachten
KI Plagiat beschreibt ein Problem, das ein klassischer Plagiatscan nicht lösen kann. Ein Plagiatscan sucht nach Übereinstimmungen zwischen dem hochgeladenen Text und Texten, die bereits in einer Datenbank oder im Internet verfügbar sind. Ein neu generierter KI-Text existiert vor seiner Erstellung noch nicht als Quelle in solchen Datenbanken. Die Frage, ob ein Text von einer KI erzeugt wurde, erfordert deshalb ein anderes Prüfverfahren als die Suche nach kopierten Passagen.
Die HTW Berlin hat ihre Plagiatssoftware Ouriginal zu Juni 2026 abgeschafft. Die Hochschulbibliothek nennt ausdrücklich als einen der Gründe, dass die eingesetzte Software KI-generierte Texte in deutscher Sprache nicht zuverlässig erkennen konnte. Als weiterer Grund wird die massive Kostensteigerung nach der Übernahme durch Turnitin angeführt. Dieses Beispiel zeigt, dass die dort eingesetzte Software bei der Erkennung von KI-Texten an ihre Grenzen stieß.
Plagiat-Scan ohne Anmeldung klingt nach weniger Datenspuren, doch auch ohne Login verarbeitet der jeweilige Dienst den hochgeladenen Text auf einem fremden Server. Ein Fachbeitrag zu einem Bericht des Landesbeauftragten für Datenschutz und Informationsfreiheit Nordrhein-Westfalen (LDI NRW) hält fest, dass Hochschulen Studierendendaten vor der Weitergabe an externe Plagiatssoftware pseudonymisieren müssen. Das Pseudonym darf dabei nicht der Matrikelnummer entsprechen. Die Anbieter müssen zudem sicherstellen, dass hochgeladene Texte nach der Prüfung von ihren Servern gelöscht werden.
Wer seinen Text eigenständig vor der Abgabe prüft, sollte vor dem Hochladen Name, Matrikelnummer und Betreuungsangaben aus der Datei entfernen. Außerdem lohnt es sich, in den Nutzungsbedingungen des gewählten Dienstes nachzulesen, wie lange hochgeladene Texte gespeichert bleiben und wann sie gelöscht werden. Diese Vorsicht schützt vor ungewollter Datenweitergabe, unabhängig davon, ob der Dienst eine Anmeldung verlangt oder nicht.
Plagiat als wissenschaftliches Fehlverhalten: Was der DFG-Kodex sagt
Plagiatsprüfungen im Vergleich dienen als Prüfschritt vor der Abgabe demselben Ziel: undeklarierte Übernahmen finden, bevor ein Prüfer sie entdeckt. Doch warum gilt das Plagiat in der Wissenschaft als ernstes Vergehen? Der DFG-Kodex Leitlinien zur Sicherung guter wissenschaftlicher Praxis (Version 1.2) gibt in Leitlinie 19 eine klare Antwort: Er nennt das Plagiat neben der Erfindung und Verfälschung von Daten als Tatbestand wissenschaftlichen Fehlverhaltens. Damit ordnet der Kodex das Plagiat als eigenständige Form der Verletzung guter wissenschaftlicher Praxis ein, gleichrangig mit diesen beiden anderen Tatbeständen.
Der Kodex liefert keine Prüfformel und keinen Prozentwert, ab dem ein Text als Plagiat gilt. Das Stichwort Plagiat findet sich im gesamten 30-seitigen Dokument nur an dieser einen Stelle, in Leitlinie 19. Die übrigen 18 Leitlinien behandeln andere Aspekte wissenschaftlicher Tätigkeit, darunter Betreuungsverhältnisse, den Umgang mit Forschungsdaten und die Einrichtung von Vertrauenspersonen für Verdachtsfälle.
Ein Scan vor der Abgabe ist vor diesem Hintergrund ein sinnvoller Schritt zur eigenen Qualitätssicherung. Er hilft, vergessene Belege zu entdecken und Passagen zu finden, die zu nah am Originalwortlaut geblieben sind, bevor ein Prüfer darauf aufmerksam wird. Das gibt Gelegenheit, die Arbeit noch einmal durchzugehen und offene Stellen zu schließen.
Welche konkreten Konsequenzen eine Hochschule an ein Plagiat knüpft, regelt jede Prüfungsordnung für sich. Der DFG-Kodex trifft dazu keine Aussage. Der Scan ist deshalb kein Schutzschild gegen Folgen, sondern ein Werkzeug, das bei sorgfältiger Nutzung die eigene Kontrolle vor der Einreichung unterstützt.
Quellen und Stand
- HTW Berlin Hochschulbibliothek: FAQ Ouriginal als Plagiatserkennungssoftware: bibliothek.htw-berlin.de (geprüft am 2026-09-22)
- DFG-Kodex: Leitlinien zur Sicherung guter wissenschaftlicher Praxis, Version 1.2, Leitlinie 19: www.rdm.kit.edu (geprüft am 2026-09-22)
- Freie Universität Bozen, Universitätsbibliothek: Turnitin-Anleitung für Lehrende: www.unibz.it (geprüft am 2026-09-22)
- datenschutz notizen: LDI NRW, Hochschulen dürfen externe Plagiatssoftware nutzen: www.datenschutz-notizen.de (geprüft am 2026-09-22)
Im Zusammenhang „Plagiatscan online: Ablauf, Ergebnisse richtig lesen und Grenzen kennen“ werden die zentralen Punkte gebündelt.