Wie belastbar sind GPTZero-Ergebnisse?
Ist GPTZero zuverlässig: Zahlen, Studie und Einschätzung
GPTZero liefert keine sichere Entscheidung über die Entstehung eines Textes. Studien und eine Stellungnahme zeigen Fehlerraten, Verzerrungen und Grenzen. Dieser Beitrag ordnet die Befunde ein und nennt Prüfschritte für Studierende und Lehrende.
Kurzantwort zur Zuverlässigkeit
Bei GPTZero fiel in einer unabhängigen Untersuchung jeder zweite positive Treffer falsch aus (50 Prozent); zugleich blieben acht von hundert KI-Texte unentdeckt (8 Prozent). Weber-Wulff et al. (2023) hielten das Werkzeug aufgrund dieser Befunde für den akademischen Prüfungsbetrieb für ungeeignet.
Eine weitere unabhängige Studie untersuchte GPTZero zusammen mit sechs anderen Detektoren bei Texten nicht-englischer Muttersprachler. Über alle sieben Systeme hinweg lag die durchschnittliche Falsch-positiv-Rate bei 61,22 Prozent. Diese Zahl ist kein einzelner GPTZero-Wert. Eine dritte Studie prüfte außerdem, wie sich gezielte Textvermenschlichung auf Detektoren auswirkt. Für GPTZero sank die Genauigkeit in dem getesteten DeepSeek-Datensatz nach Humanisierung auf 52 Prozent. Das Ergebnis gilt für diesen Versuchsaufbau und nicht automatisch für andere Modelle oder Versionen. Die Stellungnahme zur Prüfungspraxis bewertet KI-Detektoren insgesamt als nicht zuverlässig genug für Prüfungsentscheidungen. Weitere False Positives bei KI-Detektoren sind deshalb ein Grund, ein Ergebnis zu prüfen und nicht als alleinigen Nachweis zu behandeln.
Wer GPTZero nutzt, sollte den konkreten Testaufbau, den Textzustand und das ausgewiesene Konfidenzniveau festhalten. Für eine belastbare Einordnung müssen die Grenzen der jeweiligen Studie mitgelesen werden. Die Befunde belegen keine allgemeine Fehlerrate für deutschsprachige Texte. Sie zeigen vielmehr, dass einzelne Werte an bestimmte Texte, Datensätze und Untersuchungsbedingungen gebunden sind.
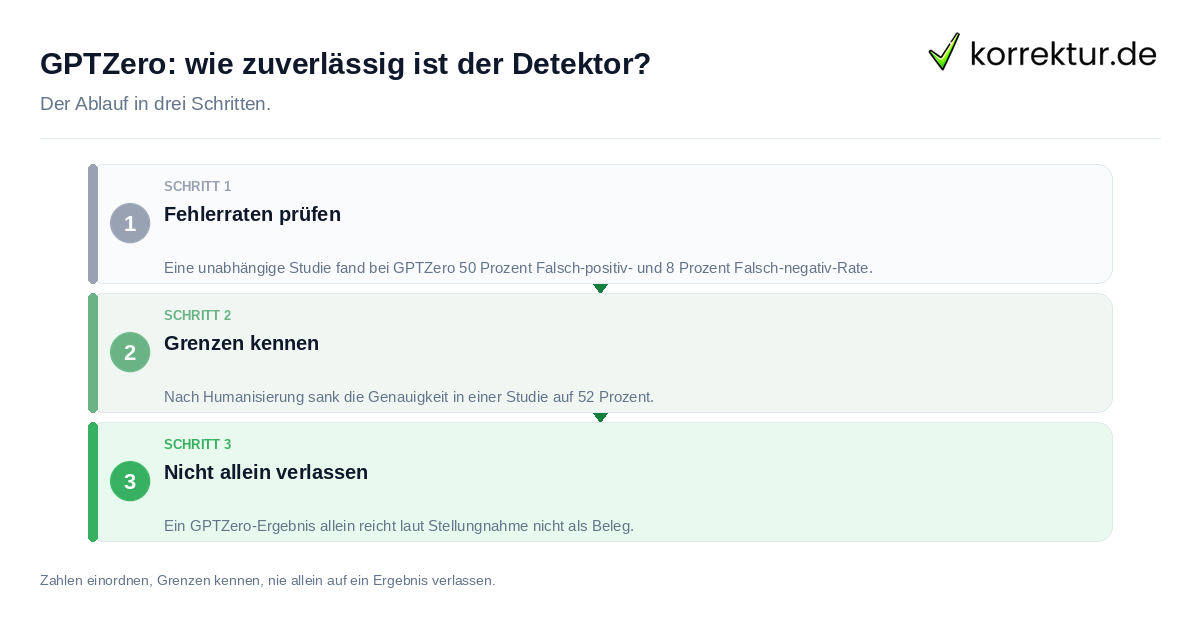
Messwerte aus der Weber-Wulff-Studie
Weber-Wulff et al. (2023) testeten 14 frei verfügbare oder kommerzielle KI-Text-Detektoren. Zu den untersuchten Werkzeugen gehörten GPTZero und Turnitin. Die Studie verglich menschliche und KI-generierte Texte sowie maschinell übersetzte und paraphrasierte Fassungen. Für GPTZero sind dabei zwei Fehlerraten ausdrücklich angegeben.
- GPTZero hatte eine Falsch-positiv-Rate von 50 Prozent.
- Die Studie weist für GPTZero eine Falsch-negativ-Rate von 8 Prozent aus.
- Damit wären laut Schlussfolgerung der Studie die Hälfte der positiven GPTZero-Klassifikationen falsche Anschuldigungen.
- Die Forschenden stuften GPTZero deshalb für den akademischen Bereich als ungeeignet ein.
- GPTZero zeigte laut Studie nicht das Muster, menschliche Texte bevorzugt richtig zu klassifizieren.
Die Werte beschreiben den damaligen Test und dürfen nicht ohne Prüfung auf deutschsprachige Texte oder neuere GPTZero-Versionen übertragen werden. Sie sind auch kein Beleg dafür, dass jede einzelne Meldung falsch ist. Wer weitere KI-Detektoren im Vergleich sehen will, findet dort Turnitin und weitere Werkzeuge neben GPTZero. Wer zwischen Turnitin oder GPTZero wählen muss, findet in der Studie beide Werkzeuge getestet. Für eine Entscheidung sollte daher zuerst geklärt werden, welcher Texttyp untersucht wurde und ob die Untersuchung zum eigenen Fall passt. Ein einzelner Prozentwert ersetzt diese Prüfung nicht.
Verzerrung bei nicht-englischen Muttersprachlern
Liang et al. (2023) testeten sieben frei verfügbare KI-Text-Detektoren, darunter GPTZero. Die Datengrundlage bestand aus TOEFL-Aufsätzen von Personen mit nicht-englischer Muttersprache und Aufsätzen US-amerikanischer Achtklässler. Der Vergleich bezog sich damit auf zwei klar benannte Gruppen und auf englische Texte. Die Aufsätze der Achtklässler erkannten die Detektoren laut Studie fast fehlerfrei. Bei den TOEFL-Aufsätzen wurden dagegen über die Hälfte fälschlich als KI-generiert eingestuft.
Über alle sieben getesteten Detektoren hinweg betrug die durchschnittliche Falsch-positiv-Rate bei den TOEFL-Aufsätzen 61,22 Prozent. Nach einer Anpassung der Wortwahl durch ChatGPT an eine muttersprachliche Ausdrucksweise sank dieser Durchschnitt auf 11,77 Prozent. Die Studie berichtet keinen einzelnen GPTZero-Wert für diese Verzerrung. Ein typischer Auswertungsfehler wäre daher, den Durchschnitt aller sieben Systeme GPTZero allein zuzuschreiben. Für GPTZero, ZeroGPT und Originality ist jeweils ein eigener Quellenbeleg zu prüfen; aus dieser Studie folgt keine GPTZero-spezifische Einzelrate.
Die Zahlen gelten für den beschriebenen englischen Datensatz und den damaligen Untersuchungsrahmen. Sie legen keine Übertragung auf deutschsprachige Texte nahe. Bei einem GPTZero-Ergebnis sollte deshalb geprüft werden, welche Sprache, Textgruppe und Bearbeitung vorlagen. Erst danach lässt sich beurteilen, ob der Befund überhaupt mit dieser Studie vergleichbar ist. Die Studie liefert einen Hinweis auf mögliche Verzerrungen, aber keine allgemeine Messung für alle Texte und alle Versionen.
Textvermenschlichung im aktuellen Studiendatensatz
Alshammari und Rao untersuchten 2025 an der University of Missouri sechs frei zugängliche KI-Detektoren, darunter GPTZero. Geprüft wurden mit DeepSeek erzeugte Texte sowie paraphrasierte und humanisierte Fassungen. Bei unverändertem, mit DeepSeek erzeugtem Text erreichte GPTZero bei menschlichen Texten eine Erkennungsquote von 98,2 Prozent. Diese Angabe beruhte auf 294 getesteten Versuchen. Sie beschreibt den Versuchsaufbau der Studie und keine allgemeine Genauigkeit für sämtliche Texte.
| Textzustand | GPTZero-Genauigkeit | Anmerkung |
|---|---|---|
| Unveränderter Datensatz | 98,2 Prozent | Erkennungsquote bei menschlichen Texten in 294 Versuchen |
| Nach Textvermenschlichung | 52 Prozent | Genauigkeit im getesteten DeepSeek-Datensatz |
Die Textvermenschlichung war in dieser Untersuchung der wirksamste getestete Angriff auf die Erkennung. Die Genauigkeit sank dabei bei GPTZero auf 52 Prozent. Zum Vergleich nennt die Studie 71 Prozent bei Copyleaks und 58 Prozent bei QuillBot. Diese Vergleichswerte sind keine Empfehlungen für eines der Werkzeuge. Sie zeigen nur, dass derselbe Angriff in der Studie unterschiedliche Ergebnisse hervorbrachte.
Aus der Untersuchung folgt nicht, dass GPTZero bei jedem KI-Modell oder bei jeder Bearbeitung auf 52 Prozent fällt. Für eine Einordnung muss daher festgehalten werden, ob DeepSeek verwendet wurde und ob eine gezielte Humanisierung vorlag. Ohne diese Angaben wäre eine Übertragung des Werts auf einen anderen Text eine unbelegte Annahme. Die Studie ergänzt die älteren Fehlerraten um einen Befund zur Veränderbarkeit der Erkennung.
Stellungnahme zur Prüfungspraxis
Die Stellungnahme „Der Einsatz von KI-Detektoren zur Überprüfung von Prüfungsleistungen“ stammt vom Digitalen Lehre Hub Niedersachsen und wurde von Baresel, Horn und Schorer verfasst. Sie trägt den Stand 24.02.2025 und gibt die Position der Universität Vechta und der Universität Oldenburg wieder. Die Stellungnahme kommt zu dem Schluss, dass KI-Detektoren wegen ihrer Unzuverlässigkeit und rechtlicher Probleme im Prüfungskontext nicht eingesetzt werden sollten.
Die Kernaussage lautet: KI-Detektoren sind nicht zuverlässig, auch wenn Prozentangaben diesen Eindruck vermitteln können. Die Stellungnahme nennt falsch-positive Ergebnisse als Problem. Dabei wird einem Prüfling KI-Nutzung unterstellt, obwohl er keine KI verwendet hat. Besonders gut strukturierte Texte werden als betroffen beschrieben. Außerdem zitiert die Stellungnahme den Disclaimer eines Anbieters: Kein Detektor sei zu 100 Prozent zuverlässig; Ergebnisse sollten nie allein für karriererelevante Entscheidungen verwendet werden.
Diese Einschätzung ist eine Stellungnahme von zwei niedersächsischen Universitäten. Sie ist keine einheitliche Vorgabe für alle deutschen Hochschulen. Wer die Gründe für Vorsicht bei KI-Detektoren für Lehrende genauer verstehen will, findet dort weitere Hintergründe zur Prüfungspraxis. Für den eigenen Fall ist die zuständige Stelle aus offiziellen Unterlagen zu ermitteln; dort genannte Regeln können zusätzlich geprüft werden. Das ersetzt keine Prüfung des Einzelfalls. Inhaltlich bleibt der zentrale Punkt: Ein Detektorergebnis trägt nach dieser Stellungnahme keine alleinige Prüfungsentscheidung.
Drei Schritte bei einem GPTZero-Ergebnis
Ein GPTZero-Ergebnis sollte als prüfbedürftige Information behandelt werden. Halte zunächst den angezeigten Wert, das genannte Konfidenzniveau und die zugehörige FAQ-Zahl fest. Notiere außerdem, welcher Text geprüft wurde und ob die Ausgabe auf einen bestimmten Textzustand Bezug nimmt. Vergleiche diese Angaben mit den Bedingungen der einschlägigen Studie.
- Wert einordnen: Lies das Konfidenzniveau und die zugehörige FAQ-Zahl vollständig. Prüfe, ob der Dienst eine Einschränkung oder einen Hinweis zur Aussagekraft nennt.
- Nicht allein entscheiden: Werte das Ergebnis nicht als einzigen Beleg für KI-Nutzung. Vergleiche die Ausgabe mit dem Text und den vorliegenden Unterlagen, ohne aus dem Detektorwert selbst eine sichere Feststellung abzuleiten.
- Zusätzlich prüfen: Wenn Zweifel bleiben, lasse den Sachverhalt zusätzlich prüfen. Ermittle die zuständige Stelle aus offiziellen Unterlagen und prüfe die dort genannten Schritte für den konkreten Prüfungskontext.
Behandle die Ausgabe auch nach diesen Schritten nicht als alleinigen Nachweis. Die zusätzliche Prüfung dient dazu, den Wert nicht isoliert zu lesen.
Am Ende sind die Grenzen von KI-Detektoren aus der genannten Stellungnahme zu berücksichtigen: Die Stellungnahme bewertet sie als nicht zuverlässig für alleinige Prüfungsentscheidungen. Wer unsicher ist, ob Plagiatsprüfung oder KI-Detektor die passende Prüfung ist, sollte beide Wege verstehen, bevor er sich auf ein Ergebnis verlässt.
Quellen und Stand
- Weber-Wulff et al. (arXiv 2306.15666, 2023): Testing of Detection Tools for AI-Generated Text: arxiv.org (geprüft am 2026-09-15)
- Liang, Yuksekgonul, Mao, Wu, Zou (arXiv 2304.02819, 2023): GPT detectors are biased against non-native English writers: arxiv.org (geprüft am 2026-09-15)
- Alshammari, Rao (University of Missouri, arXiv 2507.17944, 2025): Evaluating the Performance of AI Text Detectors, Few-Shot and Chain-of-Thought Prompting Using DeepSeek Generated Text: arxiv.org (geprüft am 2026-09-15)
- Digitale Lehre Hub Niedersachsen (Uni Vechta, Uni Oldenburg): Der Einsatz von KI-Detektoren zur Überprüfung von Prüfungsleistungen, Eine Stellungnahme: www.uni-hannover.de (geprüft am 2026-09-15)