False positives im Detektor erkennen und entkräften
Typische Fehlalarme und was wirklich dagegen hilft
Ein Detektor markiert deine Arbeit als „wahrscheinlich KI-generiert“, obwohl du jede Zeile selbst getippt hast. Solche Detektor-Fehlalarme passieren häufiger, als du denkst. Hier liest du, warum es passiert und wie du den Verdacht konkret entkräften kannst. Den vollständigen Überblick zur Erkennung liefert der KI-Detektor für Uni-Texte.
Wie oft false positives wirklich vorkommen
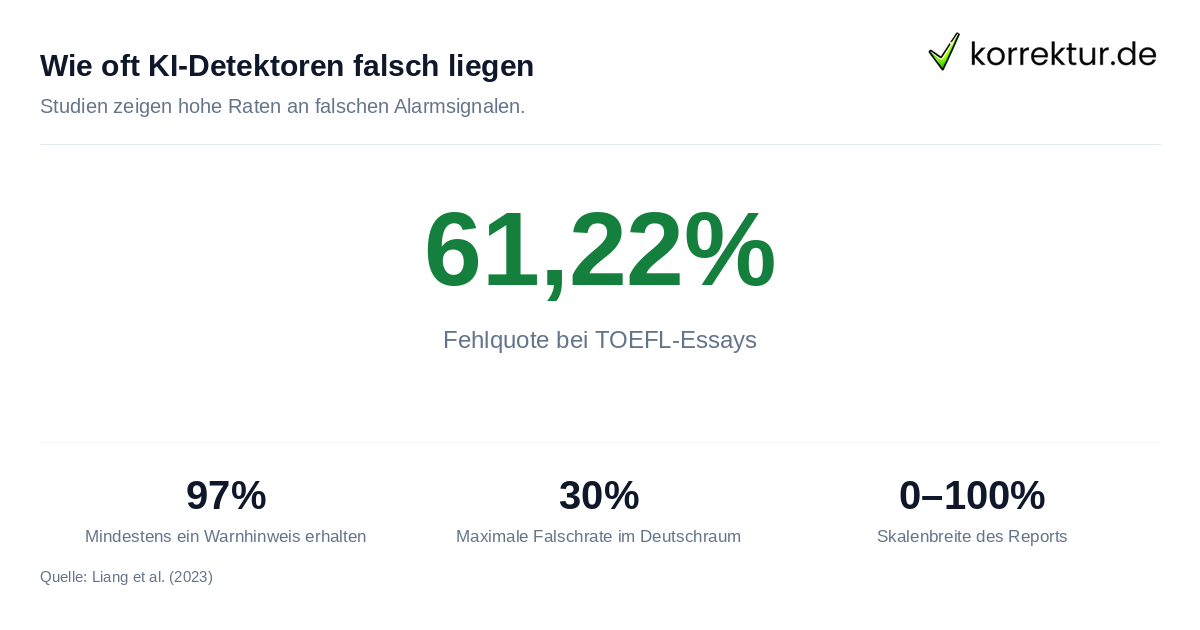
Falsche Alarme sind kein Nischenthema, sondern ein messbares Problem. Die Stanford University war an einer Studie von Liang et al. (2023) beteiligt, die sieben gängige Tools an 91 englischsprachigen TOEFL-Essays von Nicht-Muttersprachlern untersuchte. Das Ergebnis für diese Gruppe: Im Schnitt stuften die Systeme 61,22 % der Texte fälschlich als KI-generiert ein, und 97 % der Essays wurden von mindestens einem Tool markiert. Bei englischsprachigen Essays US-amerikanischer Achtklässler, also von englischen Muttersprachlern, war die Fehlklassifikation dagegen nahezu nicht vorhanden.
Auch im deutschsprachigen Raum berichten Hochschulrechtsexperten und IT-Magazine 2025 von Falsch-Positiv-Raten von bis zu 30 %, abhängig von Tool, Textsorte und Disziplin. Die Ruhr-Universität Bochum (2025) zeigte zudem, dass Lehrende KI-Texte nur begrenzt zuverlässig identifizieren. Fazit: Ein roter Balken im Detektor-Report ist ein Verdacht, kein Beweis.
So liest du den Bericht
False positives: Deinen Prüfwert souverän einordnen
Ein KI-Wert ohne Maßstab sagt wenig. Diese Skala setzt deinen Prozentwert ins Verhältnis, vom grünen Anfang bis zum roten Ende.

Den vollständigen Überblick gibt der Ratgeber Aussagekraft und Grenzen der Prüfung.
Muster, die Systeme häufig falsch markieren
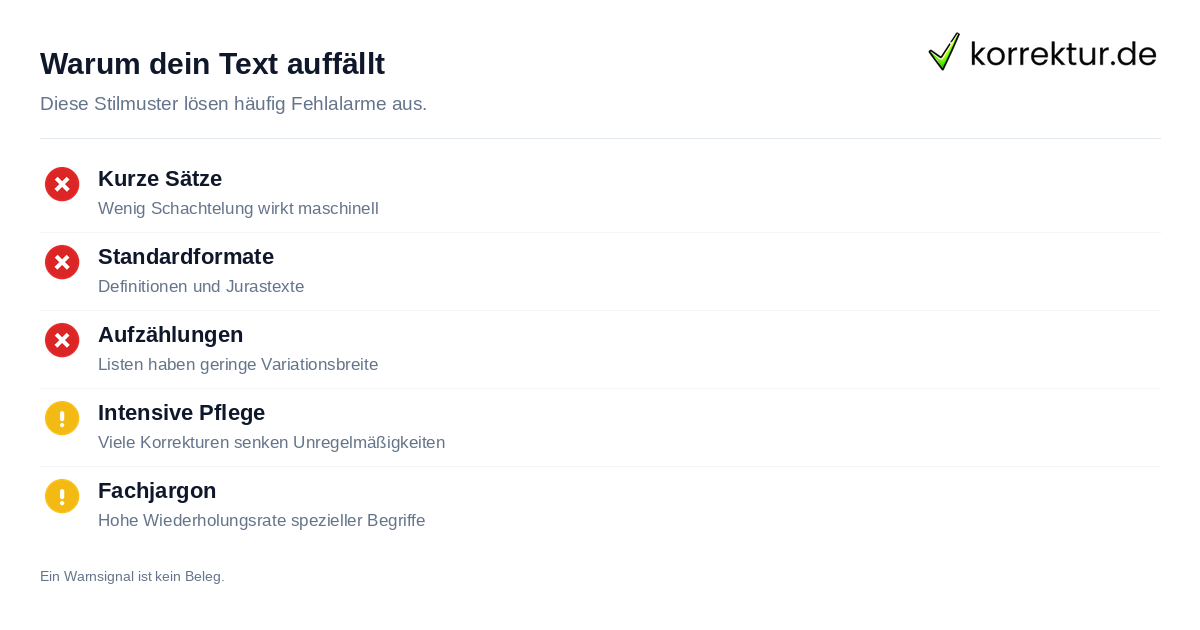
KI-Detektoren können statistische Kennzahlen wie Perplexity und Burstiness auswerten. Je nach Tool können gleichmäßige oder vorhersehbare Formulierungen zu einer Markierung beitragen. Auch menschliche Texte können solche Muster aufweisen:
- Sehr klare, schulisch saubere Sprache, kurze Sätze, einfache Konnektoren, wenig Schachtelung. Das kann bei sorgfältigen Schreibenden und bei Nicht-Muttersprachlern vorkommen.
- Standardisierte Textsorten wie Methodenkapitel, Definitionen, juristische Gutachten oder Lebensläufe. Ihr Wortschatz kann stärker eingegrenzt sein.
- Listen, Aufzählungen, Bullet-Texte, sie weisen häufig weniger stilistische Variation auf.
- Texte nach intensivem Lektorat oder nach der Nutzung einer Grammatikhilfe. Wer Füllwörter streicht, kann für einen Detektor schneller wie eine Maschine wirken.
- Übersetzte Passagen, zum Beispiel ein englisches Zitat, das ins Deutsche übertragen wurde. Auch sie können statistische Sprachmuster verändern.
- Eigene Fachsprache mit wiederkehrenden Termini, ein Merkmal präziser Wissenschaftssprache, das ein Detektor dennoch auffällig bewerten kann.

Präventiv schreiben: Belege sammeln, während du tippst
Eine gute Dokumentation des Schreibprozesses kann im Ernstfall nachvollziehbar machen, wie dein Text entstanden ist:
- Versionsverlauf einschalten. Speichere das Dokument in OneDrive oder SharePoint, aktiviere in Word 365 AutoSpeichern und kontrolliere den Versionsverlauf. Datei → Optionen → Erweitert → AutoWiederherstellen alle 5 Minuten dient dagegen nur der Wiederherstellung nach einem unerwarteten Programmende.
- Eine einzige Datei nutzen, statt ständig Copy-Paste zwischen Dokumenten. Eine durchgehende Bearbeitungs-Historie kann ein hilfreicher Nachweis sein.
- Recherche separat ablegen. Zitate, Screenshots und Quellen in einem Extra-Dokument sammeln, nicht direkt in den Fließtext kippen.
- Eigenen Schreibstil zeigen. Dokumentiere deinen Entwurf und deine Überarbeitungen, statt den Text gezielt an vermutete Detektor-Kriterien anzupassen.
- KI-Nutzungserklärung ausfüllen, sofern deine Hochschule eine verlangt. Transparenz über zulässige Hilfsmittel ist wichtiger als ein einzelner Detektorwert.
Was tun, wenn dein Text fälschlich markiert wurde
Bleib ruhig, wenn ein Prüfer dich mit einem falsch-positiven Detektor-Ergebnis konfrontiert. Du kannst den Entstehungsprozess deines Textes erläutern und Belege vorlegen:
- Fordere den vollständigen Report an. Frage nach Tool, Version und Schwellenwert. Verschiedene Detektoren können denselben Text unterschiedlich bewerten.
- Lege den Versionsverlauf offen. Eine 60-Minuten-Aufzeichnung mit echten Tippfehlern, Pausen und Umformulierungen kann zusätzliche Hinweise auf den Schreibprozess liefern.
- Teste den Text bei mehreren Detektoren. Sagt ein Tool 90 % „KI“ und drei andere nur 5 %, zeigt das, dass Detektorwerte voneinander abweichen können; daraus folgt für sich allein kein Nachweis.
- Beziehe dich auf die Studienlage. Die Stanford-Studie von 2023 zeigt, dass Detektoren menschliche Texte fehlklassifizieren können. Ein Detektor-Treffer sollte daher nicht isoliert als Beweis bewertet werden.
- Biete eine Schreibprobe an. Ein kurzer, beaufsichtigter Text vor Ort kann helfen, deinen Schreibstil und den Entstehungsprozess im Gespräch einzuordnen.
- Schalte die Hochschulberatung ein. AStA, Ombudsstelle oder Rechtsberatung können dir Anlaufstellen nennen, falls aus dem Verdacht ein offizielles Verfahren wird.

Realistisch bleiben: Welche Prüfwerte normal sind
Ein roter Balken bedeutet nicht automatisch ein Problem. Allgemeingültige Prüfwerte gibt es nicht: Auch Angaben wie 5 bis 25 % „KI-Wahrscheinlichkeit“ oder 100 % lassen ohne Angaben zu Tool, Version, Textsorte und Prüfbedingungen keinen sicheren Schluss auf die Textentstehung zu. Der Wert ist ein Hinweis und kein Herkunftsnachweis.
Auch wenn zwei verschiedene Detektoren unter 20 % anzeigen, lässt sich daraus keine verlässliche Entwarnung ableiten. Weicht ein einzelnes Tool deutlich ab, prüfe die oben genannten Risiko-Passagen, Methode, Definitionen, übersetzte Stellen, und dokumentiere den Schreibprozess.
Studien zum Thema
- Liang et al. (2023): Sieben gängige KI-Detektoren stuften 61,22 % der 91 englischsprachigen TOEFL-Essays von Nicht-Muttersprachlern fälschlich als KI-generiert ein; 97 % wurden von mindestens einem Tool markiert. Quelle
- Ruhr-Universität Bochum (2025): Die Universität berichtete über ein laufendes Folgeprojekt zur Erkennung KI-generierter Texte durch Lehrende. Eine allgemeine Falsch-Positiv-Rate von 30 % für deutschsprachige Texte lässt sich daraus nicht ableiten. Quelle
Beispiele aus der Beratungspraxis können sehr unterschiedlich ausfallen. Als Gegenmittel gegen einen Detektor-Verdacht können ein Versionsverlauf, handschriftliche Notizen und Rechercheunterlagen helfen, den Schreibprozess zu erläutern. Auch das Angebot, unter Aufsicht weiterzuschreiben, kann die Einordnung unterstützen. Diese Belege ersetzen jedoch nicht die Prüfung der Regeln und des konkreten Einzelfalls durch die Hochschule.
Häufige Fragen zu Fehlalarmen
Wie häufig sind falsche Treffer wirklich?
Häufig genug, um sie ernst zu nehmen. In der Studie von Liang et al. (2023) stuften sieben Tools im Schnitt 61,22 % der TOEFL-Essays von Nicht-Muttersprachlern fälschlich als KI-generiert ein, 97 % wurden von mindestens einem Tool markiert. Bei Muttersprachlern war die Fehlklassifikation nahezu nicht vorhanden.
Wen trifft ein Fehlalarm am ehesten?
Vor allem Schreibende, deren Sprache gleichmäßig und vorhersehbar wirkt. Das betrifft Nicht-Muttersprachler besonders stark, aber auch sorgfältige akademische Prosa: Eine sauber formulierte Einleitung oder ein nüchterner Theorieteil liefert oft hohe Werte, ohne dass ein einziges Wort aus einem Sprachmodell stammt.
Was mache ich, wenn mein Text fälschlich markiert wurde?
Belege deinen Schreibprozess, statt zu diskutieren: Versionsverlauf, Zwischenstände, Notizen und Rechercheprotokolle zeigen, wie der Text entstanden ist. Ein roter Balken im Report ist ein Verdacht, kein Beweis, und genau so lässt er sich entkräften.
Kann ein Detektor beweisen, dass ich selbst geschrieben habe?
Nein, in keine Richtung. Ein Detektor misst statistische Auffälligkeiten und gibt eine Wahrscheinlichkeit aus. Weder ein niedriger noch ein hoher Wert ist ein Herkunftsnachweis. Die Ruhr-Universität Bochum zeigte 2025 zudem, dass auch Lehrende KI-Texte nur begrenzt zuverlässig erkennen.