Kovarianz fachlich einordnen und anwenden
 Fachlich geprüft von Benjamin Lohrer, Lektor bei korrektur.de · Stand: 15. August 2026
Kovarianz verständlich erklärt
Kovarianz beschreibt eine Rechengröße für zwei Zufallsvariablen. Die Erklärung führt von der Definition über die Berechnung bis zur Prüfung einer eigenen Anwendung.
Kovarianz im Studium fachlich einordnen und verstehen
In der Wahrscheinlichkeitsrechnung und Statistik dient die Kovarianz als zentrales Maß, um die gemeinsame Abhängigkeit zweier Zufallsvariablen rechnerisch zu bestimmen. Betrachtet werden dabei zwei Zufallsgrößen, die klassisch mit X und Y bezeichnet werden und sowohl diskrete als auch kontinuierliche Ausprägungen annehmen können. Als feste Bezugspunkte für die Lage der beiden Verteilungen gehören zu ihnen die jeweiligen Mittelwerte μX und μY.
In Fachliteratur, Vorlesungsskripten und Abschlussarbeiten werden vor allem die Kurzformen Cov(X,Y) sowie σXY als symbolische Bezeichnungen genutzt. Mathematisch ist dieses Zusammenhangsmaß über die Grundgleichung Cov(X,Y) = E[(X - μX)(Y - μY)] festgelegt. Damit wird die Kovarianz verständlich erklärt: Man bestimmt zunächst für beide Zufallsgrößen die jeweiligen Abweichungen von ihren Mittelwerten, multipliziert diese miteinander und bildet anschließend über das resultierende Produkt den Erwartungswert.
Wer im Studium statistische Herleitungen und Beweisgänge sicher durchdringen und das Gelernte fehlerfrei auf neue Übungsaufgaben übertragen möchte, braucht eine saubere Struktur. Um in Hausarbeiten, Klausuren oder empirischen Auswertungen die Kovarianz fachlich einordnen und anwenden zu können, sollte sich die schriftliche Darstellung konsequent an der formalen Definition sowie an klar nachvollziehbaren Zwischenschritten orientieren.
Vor jedem Rechengang ist zwingend zu klären, ob diskrete oder kontinuierliche Zufallsvariablen vorliegen, weil beide Verteilungstypen eigene Berechnungsformeln verlangen. Weiterführende Aussagen oder Interpretationen, die über die unmittelbare Definition und den gewählten Rechenweg hinausreichen, gehören in wissenschaftlichen Texten nur dann in die Auswertung, wenn sie durch eine belastbare Fachquelle abgesichert sind.
Formale Definition, zentrale Merkmale und Rechenformen
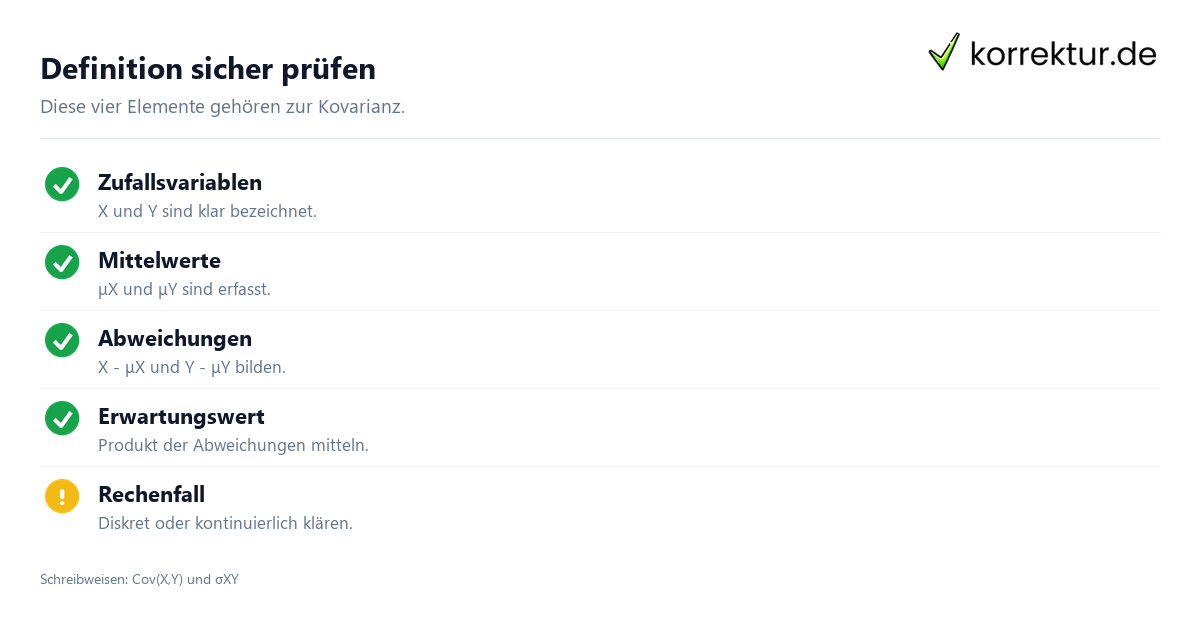
Mathematisch greift die allgemeine Definition immer dann, wenn sowohl die beiden Mittelwerte als auch der Erwartungswert für das Produkt der Abweichungen existieren. Vier eng miteinander verknüpfte Bestandteile bilden dabei das Fundament: die betrachteten Zufallsvariablen X und Y, deren zugehörige Mittelwerte μX und μY, die einzelnen Differenzen X - μX und Y - μY sowie der über das Abweichungsprodukt gebildete Erwartungswert. Zusammengefasst münden diese Elemente in die kompakte Definitionsgleichung Cov(X,Y) = E[(X - μX)(Y - μY)].
Dieser Grundausdruck bildet für diskrete und stetige Zufallsvariablen gleichermaßen den Ausgangspunkt, sofern die Existenz der Mittelwerte und des erwarteten Abweichungsprodukts gesichert ist. In der konkreten Berechnung teilt sich das Vorgehen anschließend in zwei klar abgegrenzte Rechenformen auf. Liegen diskrete Zufallsgrößen vor, stützt sich die Berechnung auf die gemeinsame Wahrscheinlichkeitsfunktion f(x,y) sowie auf den gemeinsamen Träger S:
Cov(X,Y) = ΣΣ über (x,y) in S von (x - μX)(y - μY) f(x,y)
Für jedes einzelne Wertepaar innerhalb des Trägers S werden dabei die beiden Mittelwertabweichungen bestimmt und mit dem jeweiligen Funktionswert f(x,y) gewichtet. Anschließend fasst die Doppelsumme die gewichteten Produkte über sämtliche zulässigen Wertepaare des gemeinsamen Trägers zusammen.
Werden hingegen stetige Zufallsvariablen untersucht, arbeitet die Berechnung mit den beiden Integrationsbereichen S1 und S2 sowie mit der gemeinsamen Wahrscheinlichkeitsdichte f(x,y). An die Stelle der diskreten Doppelsumme rückt im kontinuierlichen Fall folgerichtig ein Doppelintegral:
Cov(X,Y) = ∫ über S2 ∫ über S1 (x - μX)(y - μY) f(x,y) dx dy
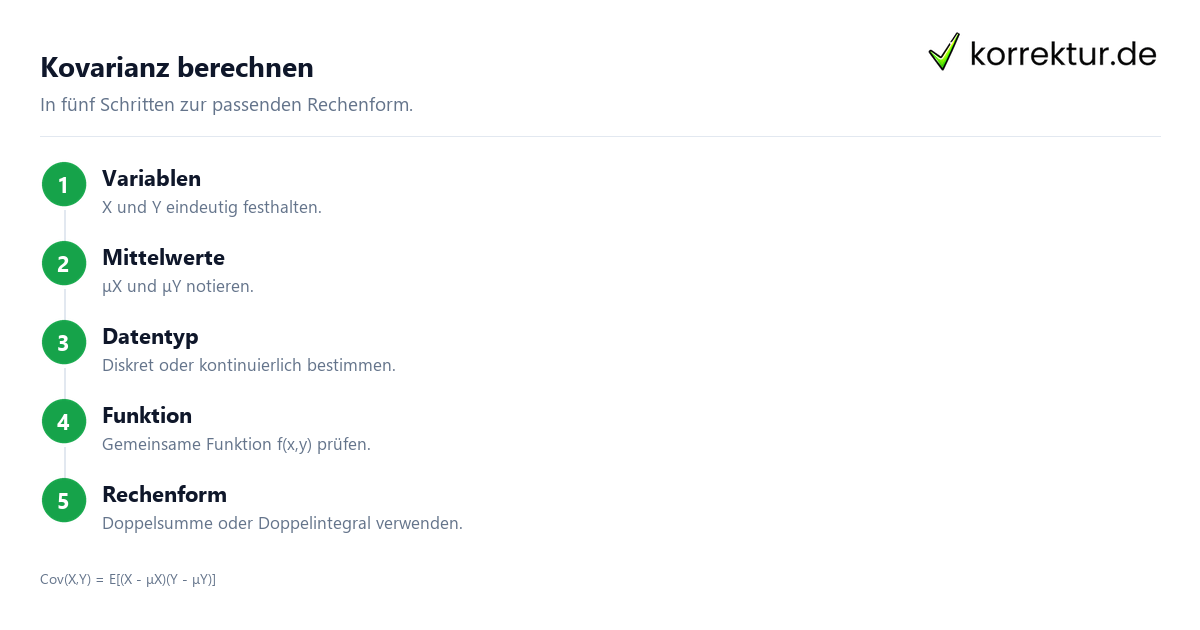
Für die praktische Umsetzung ergibt sich daraus eine klare Reihenfolge: Zuerst werden die beteiligten Zufallsgrößen und ihre Mittelwerte sauber dokumentiert, danach wird zwischen dem diskreten und dem kontinuierlichen Fall unterschieden und schließlich die zugehörige Summenform oder Integralform angesetzt. Noch vor dem Einsetzen von Werten sollte daher kontrolliert werden, ob die Aufgabenstellung eine diskrete Wahrscheinlichkeitsfunktion oder eine stetige Dichtefunktion vorgibt.
Kovarianz Schritt für Schritt berechnen: Anleitung für die Praxis
- Zufallsvariablen eindeutig benennen: Notiere zu Beginn die beiden untersuchten Größen klar als
XundY, damit alle folgenden Terme zweifelsfrei zugeordnet sind. - Zugehörige Mittelwerte festhalten: Bestimme oder übernimm aus der Aufgabenstellung die Werte für
μXundμY, da beide Lagemaße für die anschließende Differenzbildung benötigt werden. - Verteilungsart bestimmen: Kläre anhand der Angaben, ob diskrete oder kontinuierliche Zufallsgrößen vorliegen, um gezielt zwischen der Summenform und der Integralform zu wählen.
- Gemeinsame Verteilung zuordnen: Nutze bei diskreten Größen die gemeinsame Wahrscheinlichkeitsfunktion
f(x,y)auf dem gemeinsamen TrägerS; greife bei stetigen Größen auf die TrägerS1undS2sowie die gemeinsame Wahrscheinlichkeitsdichtef(x,y)zurück. - Einzelne Abweichungen aufstellen: Bilde für jedes betrachtete Wertepaar separat die beiden Differenzen
x - μXundy - μYals Maß für die jeweilige Distanz zum Mittelwert. - Abweichungsprodukt berechnen: Verknüpfe beide Differenzen multiplikativ zum Ausdruck
(x - μX)(y - μY), der den Kernbestandteil der Summe beziehungsweise des Integranden darstellt. - Mit der Wahrscheinlichkeit gewichten: Multipliziere im diskreten Rechengang jedes Abweichungsprodukt mit dem zugehörigen Funktionswert
f(x,y), um den gewichteten Einzelbeitrag des Wertepaares zu erhalten. - Gesamtwert zusammenführen: Summiere im diskreten Fall sämtliche gewichteten Einzelbeiträge über den Träger
Sauf oder integriere im kontinuierlichen Fall über die BereicheS1undS2, sodass als ResultatCov(X,Y)entsteht. - Ergebnis formal ausweisen: Dokumentiere das Endergebnis abschließend unter der Fachbezeichnung
Cov(X,Y)oderσXY, damit Definition, Rechenweg und Resultat nachvollziehbar verbunden sind.
Durch diese klare Abfolge entsteht nach jedem Arbeitsschritt ein überprüfbares Zwischenresultat. Dadurch fällt bei der Kontrolle sofort auf, falls ein Mittelwert verwechselt, ein Wertepaar ausgelassen oder die Gewichtung mit der gemeinsamen Funktion übersehen wurde.
Durchgängiges Rechenbeispiel für diskrete Zufallsvariablen
Wie die Berechnung in der Praxis ineinandergreift, zeigt ein kompaktes Übungsbeispiel mit zwei diskreten Zufallsvariablen. Im gemeinsamen Träger treten hierbei lediglich zwei Wertepaare auf, nämlich (x,y)=(-1,-1) sowie (x,y)=(1,1). Beide Merkmalskombinationen besitzen jeweils die gemeinsame Eintrittswahrscheinlichkeit 0,5, womit die gemeinsame Wahrscheinlichkeitsfunktion für diesen diskreten Anwendungsfall vollständig bestimmt ist.
Weil die beiden symmetrischen Wertepaare mit exakt demselben Gewicht in die Verteilung eingehen, liegen die Mittelwerte bei μX = 0 und μY = 0. Dadurch stimmen die jeweiligen Mittelwertabweichungen unmittelbar mit den Ausgangskoordinaten überein. Setzt man das erste Wertepaar in den gewichteten Abweichungsterm ein, ergibt sich folgender Rechenschritt:
(x - μX)(y - μY) f(x,y) = (-1 - 0)(-1 - 0) · 0,5 = 0,5
Für das zweite Wertepaar liefert das Einsetzen in denselben Produktausdruck analog:
(x - μX)(y - μY) f(x,y) = (1 - 0)(1 - 0) · 0,5 = 0,5
Werden nun beide gewichteten Einzelbeiträge über den gesamten gemeinsamen Träger aufsummiert, folgt daraus das Endergebnis:
Cov(X,Y) = 0,5 + 0,5 = 1
Anhand dieser Musterrechnung wird das Zusammenspiel aller Komponenten der diskreten Summenformel deutlich: Für die Zufallsgrößen X und Y werden zunächst die Mittelwerte herangezogen, danach für jedes Paar die Abweichungsprodukte bestimmt, diese mit den jeweiligen Wahrscheinlichkeiten gewichtet und abschließend zur Gesamtsumme zusammengefasst. Das Resultat leitet sich somit lückenlos aus der formalen Definition und den gegebenen Übungswerten ab.
Bearbeitet man in einer Klausur oder Hausarbeit eine andere diskrete Aufgabenstellung, bleibt das Rechenschema identisch, während die konkreten Ausprägungen, Mittelwerte und Wahrscheinlichkeiten neu eingesetzt werden. Sind die Zufallsgrößen dagegen kontinuierlich verteilt, darf nicht mit der Doppelsumme gerechnet werden; stattdessen ist zwingend der Integralausdruck über die beiden Trägerbereiche mit der gemeinsamen Wahrscheinlichkeitsdichte f(x,y) heranzuziehen.
Checkliste zur Kontrolle: Definition, Anwendung und Abgrenzung prüfen
Um Flüchtigkeitsfehler und methodische Ungenauigkeiten in statistischen Ausarbeitungen zu vermeiden, empfiehlt sich eine systematische Endkontrolle in vier inhaltlichen Prüfschritten: Definition, zentrale Merkmale, praktische Anwendung sowie fachliche Abgrenzung. Abgeschlossen wird dieser Durchgang durch eine gesonderte Prüfung der formalen Schreibweise.
Kontrolle der Definition: Sind beide betrachteten Zufallsvariablen X und Y klar benannt und ihre zugehörigen Mittelwerte μX sowie μY eindeutig angegeben? Wird das Zusammenhangsmaß sauber mit Cov(X,Y) oder σXY abgekürzt und durch die Ausgangsformel E[(X - μX)(Y - μY)] vollständig hergeleitet? Sollte eines dieser Grundelemente im Text fehlen, ist die definitorische Basis noch vor Beginn der eigentlichen Auswertung zu vervollständigen.
Kontrolle der Verteilungsmerkmale: Wurde sauber zwischen diskreten und stetigen Zufallsgrößen unterschieden? Bei einer diskreten Verteilung müssen die gemeinsame Wahrscheinlichkeitsfunktion f(x,y) und der gemeinsame Träger S explizit benannt sein. Liegt hingegen ein stetiger Fall vor, müssen die beiden Integrationsbereiche S1 und S2 sowie die gemeinsame Wahrscheinlichkeitsdichte f(x,y) exakt mit dem gewählten Doppelintegral übereinstimmen.
Kontrolle der Rechenschritte: Wurden zunächst für jedes Wertepaar die einzelnen Differenzen zu den Mittelwerten gebildet und erst danach miteinander multipliziert? Ist bei diskreten Daten jeder Produktterm korrekt mit f(x,y) gewichtet und über sämtliche Paare im Träger S aufaddiert worden, beziehungsweise wurde bei kontinuierlichen Daten über beide Trägerbereiche hinweg integriert? Für eine transparente Bewertung im Studium sollte jeder Teilschritt als nachvollziehbares Zwischenergebnis dokumentiert sein.
Kontrolle der methodischen Abgrenzung: Achte darauf, die Auswahl der passenden Berechnungsformel strikt von der numerischen Ausrechnung zu trennen: Während die Doppelsumme ausschließlich diskrete Verteilungen beschreibt, ist das Doppelintegral stetigen Verteilungen vorbehalten. Darüber hinaus dürfen inhaltliche Schlussfolgerungen zur Kovarianz niemals allein aus dem Begriff selbst abgeleitet werden, sondern müssen zwingend durch die formale Definition oder das konkrete Rechenergebnis gedeckt sein.
Kontrolle der formalen Notation: Überprüfe zum Schluss unabhängig von der inhaltlichen Deutung sämtliche Variablensymbole, Indizes der Mittelwerte, Klammerungen, Rechenzeichen, Summationsgrenzen, Integrationsbereiche sowie die Notation der Wahrscheinlichkeitsfunktion oder Dichtefunktion. Stelle ebenso sicher, dass der berechnete Endwert unmissverständlich als Cov(X,Y) oder σXY gekennzeichnet ist, damit die formale Darstellung wissenschaftlichen Ansprüchen genügt.
Passende nächste Schritte
So zitierst du diese Seite
Stand: 15. August 2026korrektur.de. (2026, 15. August). Kovarianz verständlich erklärt. korrektur.de. https://korrektur.de/kovarianz
„Kovarianz verständlich erklärt.“ korrektur.de, 15. Aug. 2026, korrektur.de/kovarianz. Zugriff 28. Okt. 2026.
korrektur.de (2026) Kovarianz verständlich erklärt. Verfügbar unter: https://korrektur.de/kovarianz (Zugriff: 28. Oktober 2026).
korrektur.de. „Kovarianz verständlich erklärt.“ Zuletzt geändert 15. August 2026. https://korrektur.de/kovarianz.
korrektur.de. Kovarianz verständlich erklärt [online]. 2026 [Zugriff am 28.10.2026]. Verfügbar unter: https://korrektur.de/kovarianz
Quellen und Stand
- Fachquelle: online.stat.psu.edu (zuletzt geprüft am 2026-08-15)