Logistische Regression im wissenschaftlichen Text berichten
Logistische Regression berichten
Eine logistische Regression ist nachvollziehbar, wenn Datengrundlage, abhängige Variable, einbezogene Variablen und die sichtbaren Ergebnisse mit Modelltest, Modellgüte, Koeffizienten, Standardfehlern, p-Werten, Odds Ratios und Konfidenzintervallen klar voneinander getrennt werden.
Kostenlos herunterladen
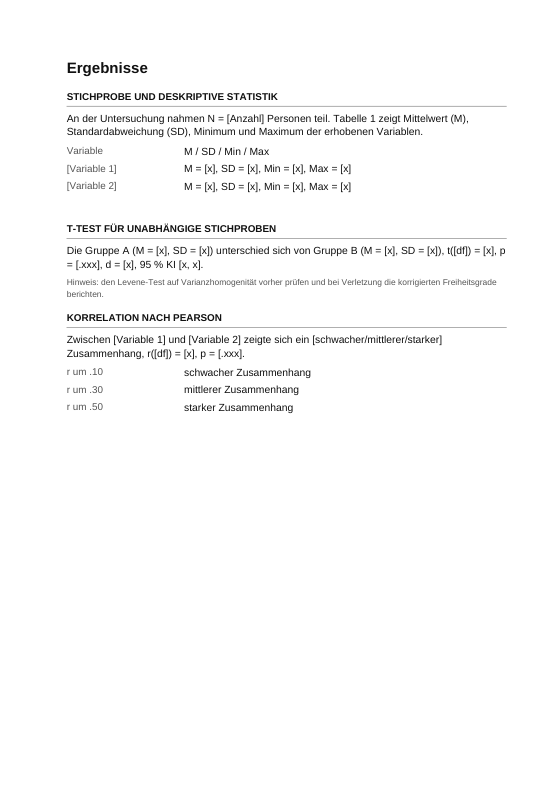
Statistik berichten: Mustersätze für den Ergebnisteil
Das fachliche Berichten der logistischen Regression auf der einen Seite, Ergebnisblätter nach APA 7 für deskriptive Statistik, t-Test und Korrelation auf der anderen: dazu Regression, Varianzanalyse, Chi-Quadrat-Test und Effektstärke.
Das SPSS-Beispiel zur logistischen Regression einordnen
Das SPSS-Beispiel veranschaulicht die logistische Regression anhand kommentierter Ausgabedaten. Für Studium und Wissenschaft kann die Darstellung am konkreten Fall überprüft werden: Sichtbar sind dort nur Angaben aus der verwendeten Syntax und Ausgabe, nicht aber Werte aus einem anderen Modell oder einem anderen Datensatz.
Der vorgestellte Datensatz umfasst 200 Schülerinnen und Schüler aus High Schools. Genannt werden Testergebnisse in Naturwissenschaften, Mathematik, Lesen und Sozialkunde. Zudem ist female eine dichotome Variable: Der Wert 1 steht für weiblich, der Wert 0 für männlich. Diese Merkmale kennzeichnen den dort verwendeten Datensatz. Bei einer eigenen Arbeit solltest du die Originaldaten und ihre Codierung stets prüfen, anstatt diese Angaben einfach zu übernehmen.
Es wird erklärt, wie die dichotome abhängige Variable honcomp aus der kontinuierlichen Variable write gebildet wird. Diese Umwandlung wird nicht empfohlen, sondern ausdrücklich nur zur Veranschaulichung gezeigt. Wenn eine eigene Arbeit eine Umcodierung zeigt, solltest du die konkrete Zuordnung, den Zweck des Schritts und die dazu sichtbare Dokumentation prüfen.
Für wissenschaftliches Schreiben ist die Trennung der Bezeichnungen hilfreich: Notiere Datensatzvariablen nur als Datensatzvariablen. Bezeichne Variablen erst dann als Modellvariablen, wenn Syntax oder Output dies trägt. Die im Datensatz genannten Testergebnisse sind damit nicht automatisch Prädiktoren des dargestellten Modells. Prüfe vor dem Formulieren, welche Variablen im jeweiligen Modell nachweislich vorkommen.
Weiterführende Themen: Bestandteile einer wissenschaftlichen Arbeit, Hausarbeit schreiben und Masterarbeit schreiben. Prüfe dafür die jeweils einschlägigen Unterlagen; das SPSS-Beispiel enthält keine Vorgaben zu Aufbau, Zulassung, Fristen, Kosten oder formalen Anforderungen.
Aufbau des gezeigten SPSS-Beispiels
Der Ablauf beginnt mit dem Laden der Datei. Der get file-Befehl gibt den Speicherpfad an. Genannt werden die Endung .sav und der abschließende Punkt. Übernimm diese Einzelheiten nur, wenn du genau diesen SPSS-Arbeitsablauf erläuterst; andernfalls prüfe die jeweilige Syntax.
Danach steht die abhängige Variable im Mittelpunkt. Im Beispiel heißt sie honcomp und wird aus write gebildet. write ist kontinuierlich, während honcomp als dichotome Zielvariable erzeugt wird. Diese Bildung dient nur der Veranschaulichung; das Beispiel empfiehlt nicht, aus kontinuierlichen Variablen dichotome Variablen zu machen. Beschreibe deshalb bei einer eigenen Auswertung nur die dokumentierte Codierung und füge keinen Zweck hinzu, den du nicht dokumentiert hast.
Als Nächstes werden die unabhängigen Variablen in der Syntax angegeben. Nach der abhängigen Variable steht das Schlüsselwort with, um kontinuierliche und kategoriale Variablen in das Modell einzubeziehen. Prüfe in der konkreten Syntax, welche Variablennamen dort nach with stehen. Bezeichne nicht alle im Datensatz vorhandenen Variablen als Modellvariablen, denn es gilt zu unterscheiden zwischen allgemeinen Datensatzangaben und den Variablen der dargestellten Modellsyntax.
Für kategoriale Variablen mit drei oder mehr Ausprägungen gibt es eine categorical-Unteranweisung. Als Beispiel dient eine dreistufige SES-Variable mit niedriger, mittlerer und hoher Ausprägung. Diese Unteranweisung veranlasst SPSS, die für die logistische Regression erforderlichen Dummyvariablen zu erstellen. Prüfe bei einer eigenen Darstellung sowohl die Zahl der Ausprägungen als auch, ob diese Unteranweisung tatsächlich verwendet wurde.
Interaktionen werden ebenfalls behandelt. Mithilfe von by können Interaktionsterme gebildet werden. Das Beispiel umfasst read, female und den Term read by female. Differenziere beim Bericht zwischen einfachen Variablennamen und Interaktionsnamen. Zur Sicherheit schaue dir die Syntax oder die passende Tabelle an.
Zum Ablauf gehört auch der Umgang mit fehlenden Werten. In der beschriebenen Standardeinstellung verwendet SPSS listenweisen Ausschluss. Für die Analyse bleiben nur Fälle, die sowohl für die abhängige Variable als auch für alle unabhängigen Variablen keine fehlenden Werte aufweisen. Diese Angabe betrifft die beschriebene SPSS-Einstellung. Prüfe die Einstellungen der eigenen Analyse, bevor du einen Satz über fehlende Werte formulierst.
Empfohlene Struktur: Datei und Datensatz checken, abhängige Variable und Kodierung verifizieren, Variablen nach with auflisten, categorical-Einstellungen prüfen, Terme via by markieren und Fehlwertlogik dokumentieren. Beschreibe nur sichtbare Ausgaben. Für Forschungsfrage formulieren und wissenschaftliche Argumentation nutze passende Literatur und analysiere gezielt.
Weitere Themen: Gliederung einer Hausarbeit, Literaturverzeichnis erstellen, Quellenangaben richtig zitieren, Zitierweisen, deutsche Zitierweise und Harvard-Zitierweise. Recherchiere die geforderte Zitationsnorm in den offiziellen Richtlinien, anstatt Annahmen zu treffen.
Schritt für Schritt zur belastbaren Darstellung der Ergebnisse
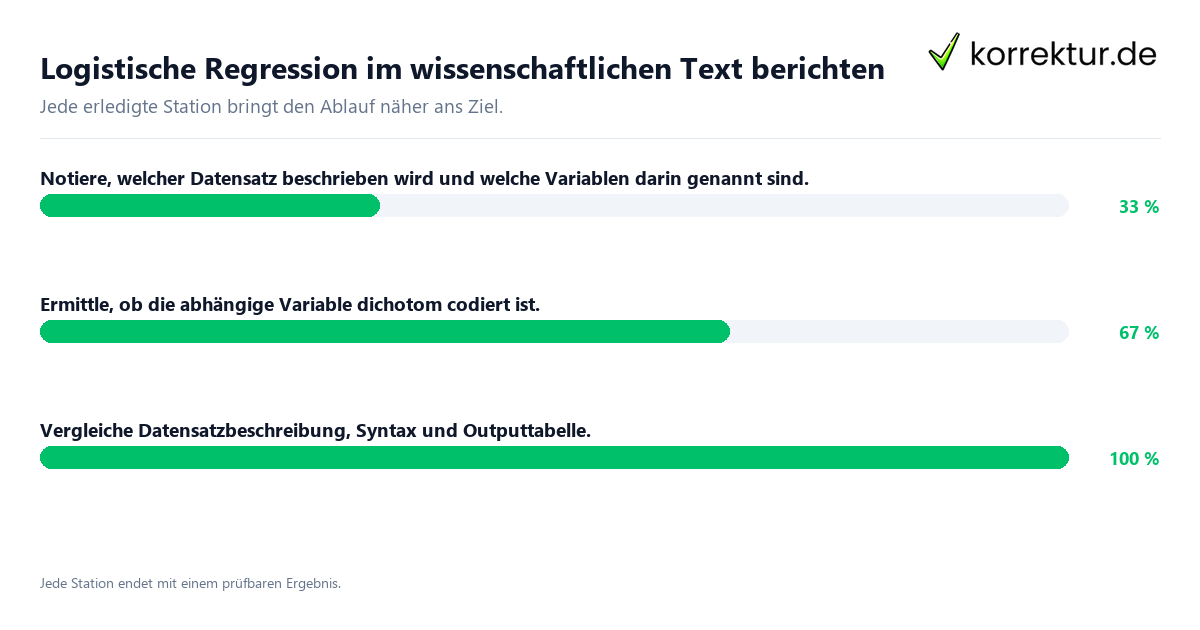
- Datenbasis erfassen. Notiere, welchen Datensatz du beschreibst und welche Variablen darin genannt sind. Am Ende steht eine getrennte Liste aus Beobachtungen, Variablen und Datensatzmerkmalen.
- Zielvariable prüfen. Ermittle, ob die abhängige Variable dichotom codiert ist. Im Beispiel wird honcomp aus write erzeugt; female ist mit 1 für weiblich und 0 für männlich codiert. Das Ergebnis ist eine dokumentierte Angabe zur Codierung und zur Herkunft der Zielvariable.
- Verwendung statt bloßer Existenz feststellen. Vergleiche Datensatzbeschreibung, Syntax und Outputtabelle. Übernimm als Modellvariable nur, was im Modell oder in der Outputtabelle nachweislich verwendet wird. Das Ergebnis ist eine belastbare Liste der einbezogenen Variablen.
- Variablentypen kennzeichnen. Trenne kontinuierliche und kategoriale Variablen. Prüfe bei kategorialen Variablen mit mehr als zwei Stufen, ob Dummyvariablen erzeugt werden. Das Ergebnis ist eine verständliche Beschreibung der Codierung im Modell.
- Interaktionen suchen. Prüfe die Syntax auf eine Modellkomponente, die zwei Variablen miteinander verknüpft. Im Beispiel wird read by female als Interaktion genannt. Das Ergebnis ist eine klare Kennzeichnung, falls eine solche Komponente tatsächlich verwendet wurde.
- Fehlende Werte dokumentieren. Prüfe, ob die beschriebene SPSS-Einstellung listenweise Fälle mit fehlenden Werten ausschließt. Das Ergebnis ist ein Satz, der den Umfang der verwendeten Fälle nicht unbesehen erweitert.
- Output getrennt auswerten. Lies die Ausgabe und übertrage nur sichtbare Angaben. Wenn ein Kennwert, eine Variable oder eine Modellkomponente nicht nachweisbar ist, formuliere keine Vermutung. Das Ergebnis ist eine Darstellung, deren einzelne Aussagen auf einer sichtbaren Stelle beruhen.
- Text an die Forschungsarbeit anbinden. Ordne die Auswertung in den eigenen Abschnitt ein und prüfe den Zusammenhang mit Methoden wissenschaftlicher Arbeiten sowie, wie qualitative und quantitative Forschung zur eigenen Aufgabe passt. Diese Begriffe dienen als Orientierung für die weitere Struktur; konkrete methodische Zuordnungen müssen aus der eigenen Aufgabe hervorgehen.
- Prüfung abschließen. Das Ergebnis ist eine eigenständige, überprüfbare Fassung.
Kurzes durchgängiges Anwendungsbeispiel für den Ergebnisbericht
Soll dein Beitrag das gezeigte SPSS-Beispiel kompakt schildern? Dann beginnst du mit der Bezeichnung der Untersuchung und den Basisdaten: Hier handelt es sich um eine logistische Regression mit Daten von Schülerinnen und Schülern an High Schools. Anschließend erklärst du die Zielgröße. Konkret wird honcomp aus write gebildet. Weil die Ursprungsdarstellung die Ableitung eines binären Merkmals aus einem stetigen Wert ausdrücklich nur exemplarisch beschreibt, erwähnst du diese Begrenzung unmittelbar.
Im nächsten Schritt kontrolliert die schreibende Person die Variablenliste. Die Variablenliste enthält Ergebnisse in Naturwissenschaften, Mathematik, Lesen und Sozialkunde. Daraus wird jedoch nicht automatisch ein Satz über alle verwendeten Prädiktoren gebildet. Stattdessen lautet der sichere Bericht: Übernommen werden nur Variablen, die die Syntax oder die Outputtabelle als Modellbestandteile ausweist. Fehlt dieser Nachweis, bleibt die konkrete Variable im Text ungenannt.
Anschließend wird die Codierung beschrieben, soweit sie dokumentiert ist. female ist dichotom codiert, mit 1 für weiblich und 0 für männlich. Falls die Syntax eine kategoriale Variable mit mehr als zwei Ausprägungen verwendet, wird geprüft, ob dafür Dummyvariablen erzeugt werden. Falls die Syntax read by female enthält, wird geprüft, ob der Begriff als Interaktionsterm ausgewiesen werden soll.
Zum Schluss ergänzt der Text den Umgang mit fehlenden Werten: In der beschriebenen SPSS-Einstellung werden nur Fälle verwendet, die für die abhängige und alle unabhängigen Variablen keine fehlenden Werte aufweisen. Als vollständiges Muster für Methoden- und Ergebnisteil gilt für genau dieses SPSS-Beispiel: Für 200 Schülerinnen und Schüler wurde eine logistische Regression mit honcomp als abhängiger Variable sowie read, science und ses als Prädiktoren gerechnet. Das Modell war insgesamt signifikant, χ²(4) = 65,588, p < 0,001; -2 Log-Likelihood = 165,701, Cox &-Snell-R² = 0,280 und Nagelkerke-R² = 0,408. Für read ergab sich B = 0,098, SE = 0,025, Wald-χ²(1) = 15,199, p < 0,001, OR = 1,103, 95%-KI [1,050; 1,158]. Diese Kennwerte gelten nur für dieses SPSS-Beispiel und nicht für andere Daten. Ohne eigene Ausgabe werden keine weiteren Kennwerte, keine zusätzlichen Schlussfolgerungen und kein Ergebnis behauptet. Wer Plagiat vermeiden möchte, formuliert die Quelle eigenständig und prüft die Übernahme einzelner Angaben am Original.
Das Beispiel zeigt eine logistische Regression in SPSS. Berichtet werden Datengrundlage, Zielvariable, nachweislich verwendete Modellvariablen, mögliche Codierungen, eine ausgewiesene Interaktion und der Umgang mit fehlenden Werten. Angaben, die nicht in der Ausgabe stehen, werden vor der Aufnahme in den Text geprüft.
Definition, Abgrenzung und formale Prüfung
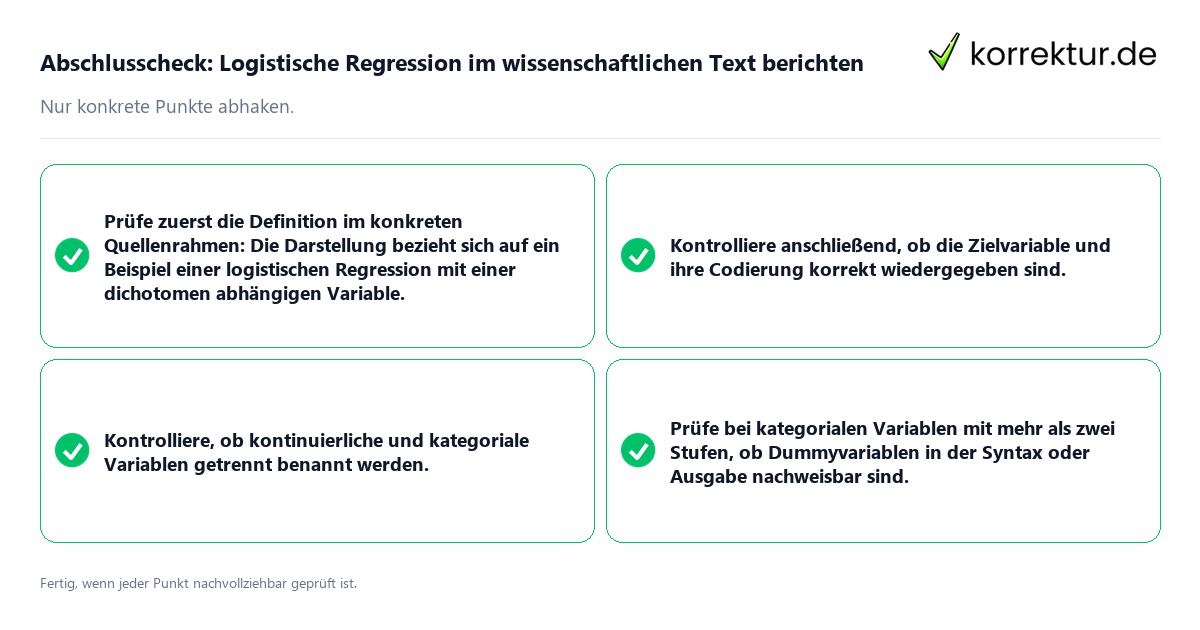
Fachliche Prüfung. Prüfe zuerst die Definition im konkreten Rahmen: Die Darstellung bezieht sich auf ein Beispiel einer logistischen Regression mit einer dichotomen abhängigen Variable. Kontrolliere anschließend, ob die Zielvariable und ihre Codierung korrekt wiedergegeben sind. Prüfe bei honcomp zusätzlich, ob deutlich bleibt, dass diese Variable aus write gebildet wurde und dass dieser Schritt nur zu Illustrationszwecken gezeigt wird.
Merkmale prüfen. Kontrolliere, ob kontinuierliche und kategoriale Variablen getrennt benannt werden. Prüfe bei kategorialen Variablen mit mehr als zwei Stufen, ob Dummyvariablen in der Syntax oder Ausgabe nachweisbar sind. Suche außerdem nach einem ausgewiesenen Interaktionsterm. Im Beispiel verbindet read by female die Variablen read und female. Fehlt ein solcher Nachweis in der eigenen Ausgabe, darf daraus kein Modellbestandteil abgeleitet werden.
Anwendung prüfen. Vergleiche jeden Satz über die Analyse mit Syntax und Outputtabelle. Die im Datensatz genannten Testergebnisse dürfen nicht ohne Nachweis als tatsächlich verwendete Prädiktoren dargestellt werden. Prüfe außerdem den Umgang mit fehlenden Werten. Für die beschriebene SPSS-Einstellung muss erkennbar sein, dass nur Fälle ohne fehlende Werte bei der abhängigen und den unabhängigen Variablen verwendet werden.
Abgrenzung. Trenne die logistische Regression von Aussagen, die das Beispiel nicht hergibt. Es enthält keine zusätzlichen statistischen Kennwerte, keine fachfremden Verfahren, keine historischen Angaben und keine institutionellen Vorgaben. Werden solche Informationen benötigt, ermittle sie aus einer passenden Originalquelle. Trenne außerdem vorhandene Variablen im Datensatz von Variablen, die tatsächlich im Modell stehen.
Formale Prüfung. Prüfe danach die eigenständige Formulierung, die Vollständigkeit der sichtbaren Angaben. Kontrolliere, ob Fachbegriffe verständlich eingeführt und nicht vorschnell verallgemeinert werden. Prüfe die passende Form für Quellenangaben richtig zitieren, ohne aus diesem Beispiel Vorgaben für deutsche oder Harvard-Zitate abzuleiten. Der letzte Kontrollpunkt lautet: Jede Tatsachenaussage lässt sich in Syntax oder Ausgabe nachvollziehen; für offene Punkte steht eine konkrete Prüfhandlung im Text.
Quellen und Stand
- Logistic Regression | SPSS Annotated Output: stats.oarc.ucla.edu (geprüft am 2026-08-21)